11. 画像データを用いた機械学習

本章では、第 10 章で学んだ古典的な特徴抽出手法を用いた画像分類の実践について学びます。また、最後に現代の画像認識の中心的手法である CNN(Convolutional Neural Network)についても簡単に紹介します。
11.1 画像分類
11.1.1 画像分類とは
画像分類の概要
画像分類(Image Classification) は、画像を見て、それがどのカテゴリに属するかを判定するタスクです。
graph LR
    A("入力画像") --> B("特徴抽出")
    B --> C("機械学習<br/>モデル")
    C --> D("クラス予測<br/>猫/犬/鳥など")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    class A data
    class B proc
    class C model
    class D out
画像分類の応用例
- 医療画像診断(X 線画像から病変を検出)
- 製品の品質検査(良品/不良品の判定)
- 文字認識(手書き文字の識別)
- 物体認識(写真に写っている物体の識別)
画像分類のワークフロー
画像分類は以下の手順で行います。
graph TB
    A("1. データ準備<br/>画像とラベル") --> B("2. 特徴抽出<br/>HOGなど")
    B --> C("3. データ分割<br/>訓練/テスト")
    C --> D("4. モデル学習<br/>分類器の訓練")
    D --> E("5. モデル評価<br/>精度の測定")
    E --> F{精度は<br/>十分?}
    F -->|No| G("6. 改善<br/>パラメータ調整")
    G --> B
    F -->|Yes| H("完成")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    classDef hl fill:#F9E7D9,stroke:#D55E00,stroke-width:2px,color:#000
    class A data
    class B,C proc
    class D model
    class E,F,H out
    class G hl
MNIST データセット
本章では、機械学習の分野で最も有名なベンチマークデータセットの一つである MNIST(Mixed National Institute of Standards and Technology) を使用します。

MNIST データセットの特徴
| 項目 | 内容 |
|---|---|
| 内容 | 0〜9 の手書き数字画像 |
| 画像サイズ | 28×28 ピクセル(グレースケール) |
| 訓練データ | 60,000 枚 |
| テストデータ | 10,000 枚 |
| クラス数 | 10(数字 0〜9) |
MNIST は 1998 年に Yann LeCun らによって公開され、以下の理由から機械学習の入門に広く使われています。
- シンプルな構造: 28×28 の小さな画像で、計算コストが低い
- 明確なタスク: 10 クラスの分類問題で、評価が容易
- 研究実績: 多くの手法のベンチマークとして使用されている
本章で使用するサブセット
オリジナルの MNIST は 70,000 枚の画像を含みますが、本講義では学習時間を短縮するため、500〜2000 枚程度のサブセットを使用します。
11.1.2 生の画素値を用いた画像分類
データセットの準備
以下では、MNIST データセットのサブセット(手書き数字)を使って、画像分類の基本を学んでいきます。サブセットデータをダウンロードし、ローカルまたはクラウドのワークスペースに配置(アップロード)したうえで、以下のコードを実行して中身を確認してみましょう。
import numpy as np
import matplotlib.pyplot as plt

# MNISTサブセットの読み込み
data = np.load('mnist_500_raw.npz')
X = data['X']  # (500, 784)  500枚の画像(各画像:28×28=784ピクセル)
y = data['y']  # (500,)  ラベル(0-9)

print(f"画像データの形状: {X.shape}")
print(f"画像の枚数: {len(X)}")
print(f"各画像のサイズ: 28×28 ピクセル")
print(f"クラス数: {len(np.unique(y))}")
print(f"クラス: {np.unique(y)}")
print(f"ラベル分布: {np.bincount(y)}")

# 画像を28×28に reshape
X_images = X.reshape(-1, 28, 28)

# サンプル画像の表示
fig, axes = plt.subplots(5, 5, figsize=(8, 8))
for i in range(25):
    ax = axes[i // 5, i % 5]
    ax.imshow(X_images[i], cmap='gray')
    ax.set_title(f'ラベル: {y[i]}')
    ax.axis('off')

plt.tight_layout()
plt.show()
画像データの形状: (500, 784)
画像の枚数: 500
各画像のサイズ: 28×28 ピクセル
クラス数: 10
クラス: [0 1 2 3 4 5 6 7 8 9]
ラベル分布: [50 50 50 50 50 50 50 50 50 50]
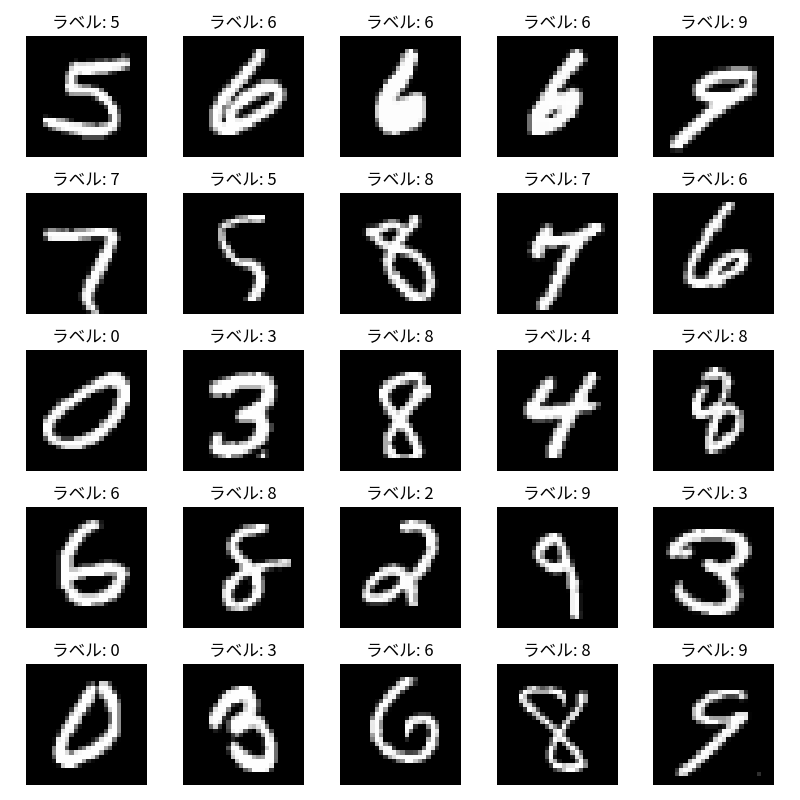
MNIST サブセット
- サイズ: 28×28 ピクセルのグレースケール画像
- 枚数: 500 枚(各クラス50枚ずつ)
- クラス: 0〜9 の手書き数字(10クラス)
- 用途: 本講義における画像分類の練習
- データセット:
- 500サンプル: data/mnist_500_raw.npz
- 1000サンプル: data/mnist_1000_raw.npz
- 2000サンプル: data/mnist_2000_raw.npz
MNIST 全体(70,000 枚)を使う場合
sklearn.datasets.fetch_openml() 関数で MNIST 全体を読み込めます。初回はネットワークから 12 MB ほどダウンロードしますが、2 回目以降はローカルにキャッシュされて高速に読み込めます。
from sklearn.datasets import fetch_openml
import numpy as np

mnist = fetch_openml('mnist_784', version=1, as_frame=False, parser='auto')
X = mnist.data.astype(np.uint8)    # (70000, 784)
y = mnist.target.astype(np.uint8)  # (70000,)
print(f"画像データの形状: {X.shape}")
print(f"ラベル分布: {np.bincount(y)}")
サブセットと同じ (N, 784) 形式の NumPy 配列が得られるので、以降のコードはそのまま動きます。ただし、サンプル数に比例して学習時間が長くなる点には注意してください。
生の画素値で分類
まずは特徴抽出をせず、生の画素値をそのまま使って 決定木(Decision Tree) で分類してみます。
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# データの読み込み
data = np.load('mnist_500_raw.npz')
X = data['X']  # (500, 784) - 生の画素値
y = data['y']

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

print(f"訓練データ: {X_train.shape}")
print(f"テストデータ: {X_test.shape}")

# 決定木
model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)

# 予測
y_pred = model.predict(X_test)

# 精度評価
accuracy = accuracy_score(y_test, y_pred)
print(f"\nテスト精度: {accuracy:.4f} ({accuracy:.2%})")

print("\n分類レポート:")
print(classification_report(y_test, y_pred))

# 混同行列の可視化
cm = confusion_matrix(y_test, y_pred)

plt.figure(figsize=(8, 6))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues', cbar_kws={'label': '件数'})
plt.xlabel('予測ラベル')
plt.ylabel('正解ラベル')
plt.title(f'混同行列(精度: {accuracy:.3f})')
plt.tight_layout()
plt.show()
訓練データ: (400, 784)
テストデータ: (100, 784)

テスト精度: 0.6000 (60.00%)

分類レポート:
              precision    recall  f1-score   support

           0       0.86      0.60      0.71        10
           1       0.82      0.90      0.86        10
           2       0.55      0.60      0.57        10
           3       0.50      0.40      0.44        10
           4       0.67      0.60      0.63        10
           5       0.50      0.70      0.58        10
           6       0.60      0.60      0.60        10
           7       0.60      0.90      0.72        10
           8       0.33      0.30      0.32        10
           9       0.67      0.40      0.50        10

    accuracy                           0.60       100
   macro avg       0.61      0.60      0.59       100
weighted avg       0.61      0.60      0.59       100
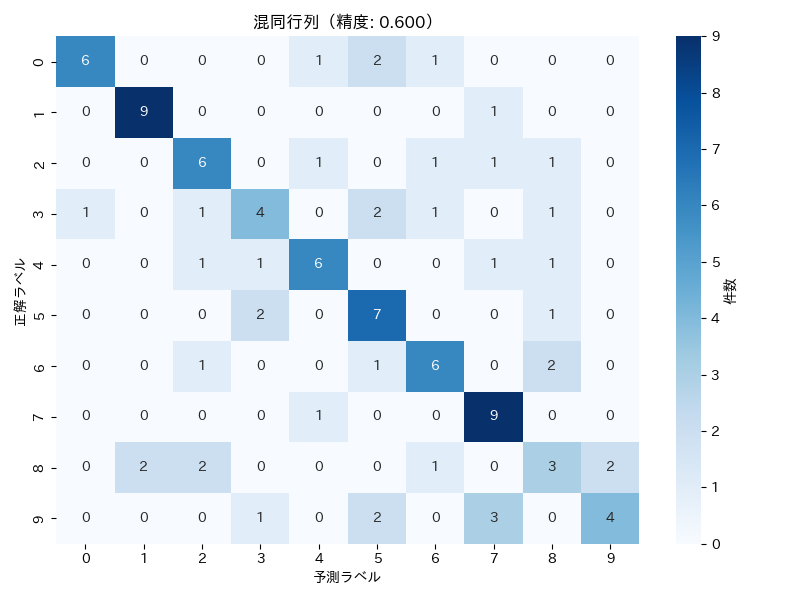
生の画素値 + 決定木の性能
精度は約 60%と、ランダム選択(10%)よりは良いですが、決定木は 1 つの画素値のしきい値で分岐するため、784 次元の生の画素値からは「どの 1 画素が決め手か」が決まらず、本質的に限界があります。次項では HOG 特徴量で形状情報を取り出し、演習 11-1 では同じ生の画素値をロジスティック回帰で扱うとどう変わるかを確認します。
誤分類された画像の確認
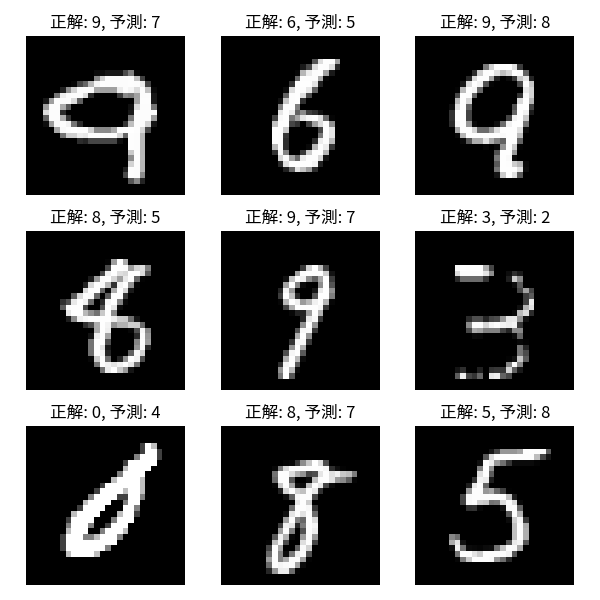
モデルがどのような画像を間違えたのかを確認することで、モデルの弱点を理解できます。弱点を理解することで、モデルの改善策(特徴量の工夫、データ拡張など)が見えてきます。
import numpy as np
import matplotlib.pyplot as plt

# 誤分類されたサンプルを抽出
misclassified_indices = np.where(y_test != y_pred)[0]
print(f"誤分類されたサンプル数: {len(misclassified_indices)}")

# 誤分類された画像を表示
if len(misclassified_indices) > 0:
    # 最大9個まで表示
    num_display = min(9, len(misclassified_indices))
    fig, axes = plt.subplots(3, 3, figsize=(9, 9))
    axes = axes.ravel()

    for i in range(num_display):
        idx = misclassified_indices[i]
        # テストデータのインデックスから元の画像を取得
        test_sample_image = X_test[idx].reshape(28, 28)

        axes[i].imshow(test_sample_image, cmap='gray')
        axes[i].set_title(f'正解: {y_test[idx]}, 予測: {y_pred[idx]}')
        axes[i].axis('off')

    # 残りのサブプロットを非表示
    for i in range(num_display, 9):
        axes[i].axis('off')

    plt.tight_layout()
    plt.show()
else:
    print("誤分類されたサンプルはありません")
Playground:手書き数字分類
手書き数字分類 の Playground では、キャンバスに 0〜9 の数字を描くと、MNIST で学習したロジスティック回帰が描いている最中ずっと予測を更新します。棒グラフは各数字である確率です。1 と 7、4 と 9 のように迷いやすい形を描くと確率が割れる様子や、モデルが実際に見ている 28×28 の入力を確かめてみましょう。
11.1.3 HOG 特徴量を用いた画像分類
HOG 特徴量の抽出
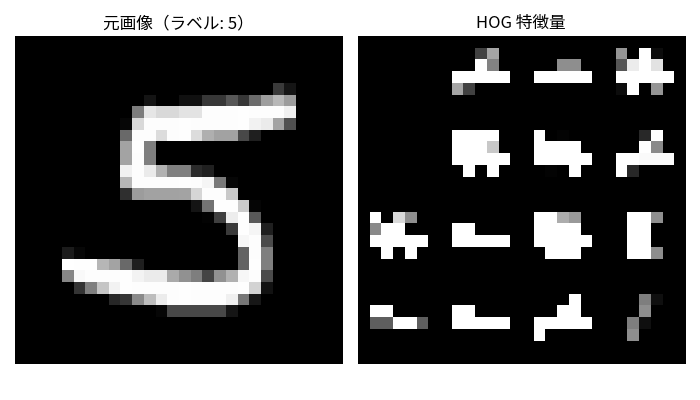
生の画素値よりも効果的な特徴表現として、HOG(Histogram of Oriented Gradients)特徴量を使うことができます。HOG はエッジの方向のヒストグラムを取ることで、画像の重要な情報を捉えます。
import numpy as np
from skimage.feature import hog
from skimage import exposure
import matplotlib.pyplot as plt

# データの読み込み
data = np.load('mnist_500_raw.npz')
X = data['X']
y = data['y']

# 画像を28×28に reshape
X_images = X.reshape(-1, 28, 28)

# HOG特徴量の抽出
hog_features = []
for image in X_images:
    fd = hog(
        image,
        orientations=9,
        pixels_per_cell=(4, 4),
        cells_per_block=(2, 2),
        visualize=False)
    hog_features.append(fd)

X_hog = np.array(hog_features)

print(f"HOG特徴量の形状: {X_hog.shape}")
print(f"各画像の特徴量次元: {X_hog.shape[1]}")
print(f"元の画素数: {X.shape[1]}")

# サンプル画像とHOG特徴量の可視化
sample_idx = 0
fd, hog_image = hog(
    X_images[sample_idx],
    orientations=9,
    pixels_per_cell=(7, 7),
    cells_per_block=(2, 2),
    visualize=True)

hog_image_rescaled = exposure.rescale_intensity(hog_image, in_range=(0, 10))

fig, axes = plt.subplots(1, 2, figsize=(7, 4))

axes[0].imshow(X_images[sample_idx], cmap='gray')
axes[0].set_title(f'元画像(ラベル: {y[sample_idx]})')
axes[0].axis('off')

axes[1].imshow(hog_image_rescaled, cmap='gray')
axes[1].set_title('HOG 特徴量')
axes[1].axis('off')

plt.tight_layout()
plt.show()
モデルの学習と評価
HOG 特徴量を使って 決定木 で分類モデルを学習するコード例は以下のようになります。11.1.2 項と同じ決定木を使い、特徴量だけを HOG に置き換えています。
import numpy as np
from skimage.feature import hog
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# データの読み込みとHOG特徴量の抽出
data = np.load('mnist_500_raw.npz')
X = data['X']
y = data['y']

X_images = X.reshape(-1, 28, 28)

hog_features = []
for image in X_images:
    fd = hog(
        image, orientations=9,
        pixels_per_cell=(7, 7),
        cells_per_block=(2, 2),
        visualize=False)
    hog_features.append(fd)

X_hog = np.array(hog_features)

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X_hog, y, test_size=0.2, random_state=42, stratify=y
)

print(f"訓練データ: {X_train.shape}")
print(f"テストデータ: {X_test.shape}")

# 決定木で学習
model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)

# 予測
y_pred = model.predict(X_test)

# 精度評価
accuracy = accuracy_score(y_test, y_pred)
print(f"\nテスト精度: {accuracy:.4f} ({accuracy:.2%})")

print("\n分類レポート:")
print(classification_report(y_test, y_pred))

# 混同行列の可視化
cm = confusion_matrix(y_test, y_pred)

plt.figure(figsize=(8, 6))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues', cbar_kws={'label': '件数'})
plt.xlabel('予測ラベル')
plt.ylabel('正解ラベル')
plt.title(f'混同行列(精度: {accuracy:.3f})')
plt.tight_layout()
plt.show()
訓練データ: (400, 324)
テストデータ: (100, 324)

テスト精度: 0.5600 (56.00%)

分類レポート:
              precision    recall  f1-score   support

           0       0.25      0.20      0.22        10
           1       0.78      0.70      0.74        10
           2       0.45      0.50      0.48        10
           3       0.60      0.60      0.60        10
           4       0.73      0.80      0.76        10
           5       0.55      0.60      0.57        10
           6       0.46      0.60      0.52        10
           7       0.71      0.50      0.59        10
           8       0.50      0.60      0.55        10
           9       0.62      0.50      0.56        10

    accuracy                           0.56       100
   macro avg       0.57      0.56      0.56       100
weighted avg       0.57      0.56      0.56       100
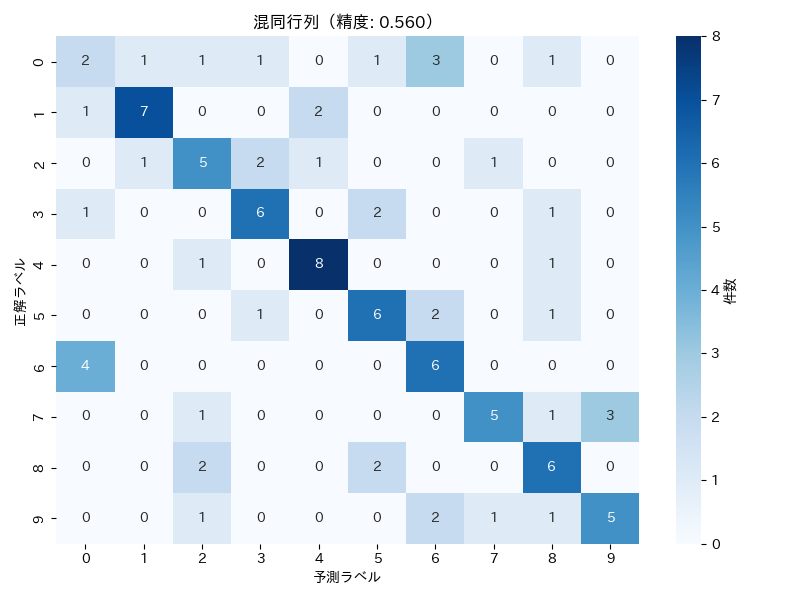
HOG + 決定木の性能
精度は約 56%。11.1.2 項の「生画素 + 決定木(60%)」とほぼ同じで、HOG にしても伸びません。HOG は 324 次元のベクトルとして勾配方向の分布を滑らかに表現しますが、決定木は 1 次元ずつしきい値で分割するため、その連続的な構造を活かしきれないためです。特徴量を改善してもモデルが合わなければ意味がない、ということを示しています。演習 11-2 で同じ HOG をロジスティック回帰で扱うとどう変わるかを確認します。
11.2 画像認識
画像に写っている物体が「何であるか」を機械に認識させるタスクを、より一般に 画像認識 と呼びます。ここでは、手書き数字よりも現実の物体認識に近い題材として、カラー画像の認識に取り組みます。ここまでは MNIST(グレースケール)を題材にしてきましたが、第 10 章演習 10-6 で学んだ RGB ヒストグラム特徴量 は、カラー画像でこそ意味を持つ手法でした。本節では、カラー画像のベンチマーク CIFAR-10 を題材に、RGB ヒストグラムを使った画像分類を実装します。
11.2.1 CIFAR-10 データセット
CIFAR-10(Canadian Institute For Advanced Research, 10 classes)は、10 種類の物体・動物のカラー画像から構成される、機械学習の代表的なベンチマークデータセットです。
| 項目 | 内容 |
|---|---|
| 内容 | 10 種類の物体・動物のカラー画像 |
| クラス | airplane / automobile / bird / cat / deer / dog / frog / horse / ship / truck |
| 画像サイズ | 32×32 ピクセル(RGB 3 チャンネル) |
| 訓練データ | 50,000 枚(オリジナル) |
| テストデータ | 10,000 枚(オリジナル) |
| クラス数 | 10 |
MNIST と同じく、本講義では学習時間短縮のため 500〜2000 枚のサブセットを使用します。
import numpy as np
import matplotlib.pyplot as plt

# CIFAR-10 サブセットの読み込み
data = np.load('cifar_500_color.npz')
X = data['X']   # (500, 32, 32, 3)  500 枚の RGB 画像
y = data['y']   # (500,)  ラベル(0-9)

class_names = ['airplane', 'automobile', 'bird', 'cat', 'deer',
               'dog', 'frog', 'horse', 'ship', 'truck']

print(f"画像データの形状: {X.shape}")
print(f"画像の枚数: {len(X)}")
print(f"クラス数: {len(np.unique(y))}")
print(f"ラベル分布: {np.bincount(y)}")

# 各クラスから 1 枚ずつサンプル表示
fig, axes = plt.subplots(2, 5, figsize=(12, 5))
for i in range(10):
    idx = np.where(y == i)[0][0]
    ax = axes[i // 5, i % 5]
    ax.imshow(X[idx])
    ax.set_title(class_names[i])
    ax.axis('off')

plt.tight_layout()
plt.show()
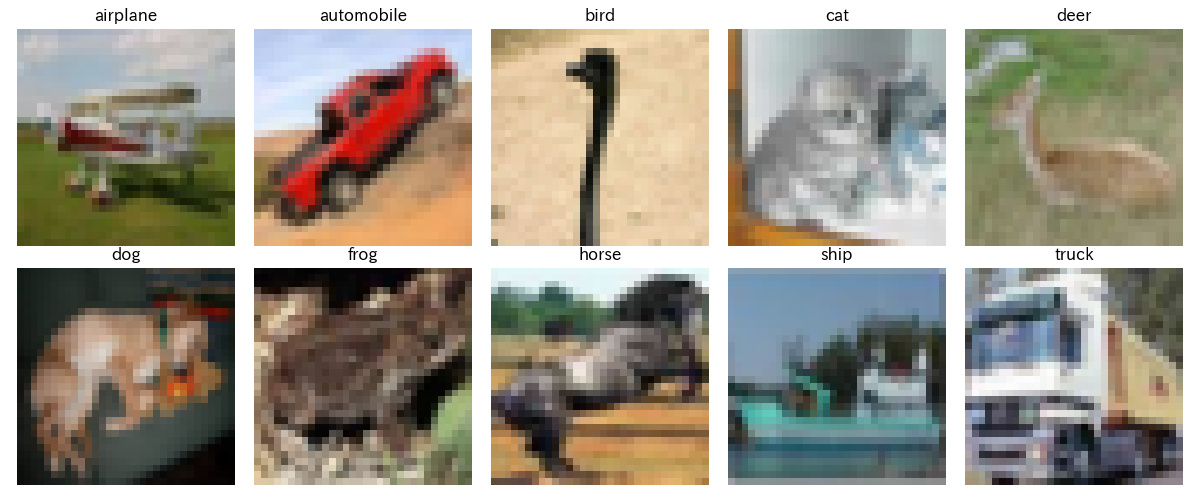
CIFAR-10 サブセット
- サイズ: 32×32 ピクセル × RGB 3 チャンネル
- 枚数: 500 枚(各クラス 50 枚ずつ)
- データセット:
- 500 サンプル: data/cifar_500_color.npz
- 1000 サンプル: data/cifar_1000_color.npz
- 2000 サンプル: data/cifar_2000_color.npz
CIFAR-10 全体(60,000 枚)を使う場合
keras 経由で CIFAR-10 全体を読み込めます(初回ダウンロード約 170 MB)。
from tensorflow.keras.datasets import cifar10

(X_train, y_train), (X_test, y_test) = cifar10.load_data()
y_train = y_train.flatten()  # (50000, 1) → (50000,) に揃える
y_test = y_test.flatten()

print(f"訓練データ: {X_train.shape}, ラベル: {y_train.shape}")
print(f"テストデータ: {X_test.shape}, ラベル: {y_test.shape}")
本講義のサブセットと同じ (N, 32, 32, 3) の uint8 配列が得られるので、以降のコードはそのまま動きます。tensorflow がインストールされていない場合は pip install tensorflow が必要です。
11.2.2 RGB ヒストグラム特徴量の抽出
第 10 章演習 10-6 で学んだように、numpy.histogram() 関数で各カラーチャンネルの画素値分布を計算できます。これを R・G・B 全チャンネルで行い、3 本のヒストグラムを連結したベクトルを 1 枚の画像の特徴量とします。各チャンネルを bins=32 のヒストグラムにすると、1 画像あたり 3 × 32 = 96 次元の特徴ベクトルが得られます。
import numpy as np

# 1 枚のカラー画像から R, G, B のヒストグラムを連結した特徴ベクトルを返す
def extract_rgb_histogram(image, bins=32):
    features = []
    for ch in range(3):
        hist, _ = np.histogram(image[:, :, ch], bins=bins, range=(0, 256))
        features.append(hist)
    return np.concatenate(features)

# 全画像から特徴量を抽出
X_hist = np.array([extract_rgb_histogram(img, bins=32) for img in X])

print(f"特徴量の形状: {X_hist.shape}")
print(f"各画像の特徴次元: {X_hist.shape[1]}")
11.2.3 モデルの学習と評価
抽出した RGB ヒストグラム特徴量を使って、11.1.2 / 11.1.3 と同じく決定木で 10 クラス分類を行います。
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X_hist, y, test_size=0.2, random_state=42, stratify=y
)

# 決定木で学習
model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)

# 精度評価
accuracy = accuracy_score(y_test, y_pred)
print(f"テスト精度: {accuracy:.4f} ({accuracy:.2%})")
print("\n分類レポート:")
print(classification_report(y_test, y_pred, target_names=class_names))

# 混同行列の可視化
cm = confusion_matrix(y_test, y_pred)
plt.figure(figsize=(10, 8))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
            xticklabels=class_names, yticklabels=class_names,
            cbar_kws={'label': '件数'})
plt.xlabel('予測ラベル')
plt.ylabel('正解ラベル')
plt.title(f'CIFAR-10 RGB ヒストグラム + 決定木(精度: {accuracy:.3f})')
plt.tight_layout()
plt.show()
11.2.4 結果の考察
RGB ヒストグラム特徴量と決定木の組み合わせで、CIFAR-10 サブセット(500 枚)に対する精度は約 19%。ランダム選択(10%)の倍程度ですが、MNIST + HOG で得られた精度には全く届きません。なぜ精度が伸びないのか、考えてみましょう。
11.3 畳み込みニューラルネットワーク(CNN)の紹介
CNN の詳細は第 14 章で
本節では CNN の概要のみを紹介します。CNN の仕組みや実装の詳細については、第 14 章で学びます。
11.3.1 CNN(畳み込みニューラルネットワーク)とは
これまで学んだ古典的な手法では、人間が特徴量を設計する必要がありました(HOG、エッジ検出など)。一方、CNN(Convolutional Neural Network: 畳み込みニューラルネットワーク) は、データから自動的に特徴量を学習するディープラーニングの手法です。
graph TB
    A("古典的手法") --> B("人間が特徴量を設計<br/>HOG, SIFT, エッジなど")
    B --> C("機械学習で分類<br/>ロジスティック回帰, SVMなど")

    D("CNN ディープラーニング") --> E("データから自動で<br/>特徴量を学習")
    E --> F("学習した特徴量で<br/>分類")

    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef neu fill:#F2F2F2,stroke:#8C8C8C,stroke-width:2px,color:#000
    class A,D neu
    class B,E proc
    class C,F model
11.3.2 CNN の基本構造
CNN は主に以下の層から構成されます。
graph TB
    A("入力画像") --> B("畳み込み層<br/>Convolution")
    B --> C("プーリング層<br/>Pooling")
    C --> D("畳み込み層<br/>Convolution")
    D --> E("プーリング層<br/>Pooling")
    E --> F("全結合層<br/>Dense")
    F --> G("出力<br/>クラス予測")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    class A data
    class B,C,D,E proc
    class F model
class G out主要な構成要素:
-
畳み込み層(Convolutional Layer)
- フィルタ(カーネル)を画像上でスライドさせて特徴を抽出
- 第 10 章で学んだ Sobel フィルタと同じ原理
- CNN では、フィルタの値をデータから自動的に学習
-
プーリング層(Pooling Layer)
- 特徴マップのサイズを削減
- 位置のずれに対する不変性を高める
- 最大プーリング(Max Pooling)が一般的
-
全結合層(Fully Connected Layer)
- 抽出された特徴から最終的なクラス予測を行う
Playground:CNN の基礎
CNNの基礎 の Playground では、「入力 → 畳み込み → プーリング」の流れを MNIST の数字画像で追えます。カーネル(縦エッジ・横エッジ・斜めエッジなど)を切り替えると特徴マップが即座に変わり、そのカーネルが反応した場所だけが白く光ります。最大プーリングと平均プーリングを切り替えて、特徴マップが縮んで位置ずれに強くなる様子も確認してみましょう。
11.3.3 古典的手法と CNN の比較
| 項目 | 古典的手法(HOG + 機械学習) | CNN(ディープラーニング) |
|---|---|---|
| 特徴設計 | 人間が設計 | データから自動学習 |
| 精度 | 特徴設計とデータに依存 | データと設計に依存 |
| 必要なデータ量 | 比較的少量でも試しやすい | 一般により多く必要 |
| 計算コスト | 比較的低い | 比較的高い(GPUが有効) |
| 解釈性 | 設計した特徴を確認しやすい | 内部表現の解釈に工夫が必要 |
| 実装の難易度 | 比較的簡単 | やや複雑 |
CNN の学習条件
CNN を初期状態から学習する場合は、多くのラベル付きデータと計算資源が必要になります。学習済みモデルを利用する方法もあります。精度はデータ・分割・モデル・学習条件によって異なるため、同じ評価条件で比較します。
11.3.4 CNN の学習プロセス
CNN は以下のような流れで学習します。
graph TB
    A("訓練データ<br/>画像+ラベル") --> B("CNN モデル")
    B --> C("予測結果")
    C --> D("損失計算<br/>予測と正解の差")
    D --> E("誤差逆伝播")
    E --> F("フィルタの更新")
    F --> B

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    class A data
    class B model
    class C out
class D,E,F proc- 順伝播: 画像を入力し、フィルタを通して予測
- 損失計算: 予測と正解の差を計算
- 逆伝播: 損失を小さくするようにフィルタを更新
- これを繰り返してフィルタを最適化
CNN を学ぶには
CNN の詳細な実装を学ぶには、以下のフレームワークを使用します。
- TensorFlow / Keras: Python の代表的なディープラーニングフレームワーク
- PyTorch: 研究でよく使われるフレームワーク
興味がある方は、第 14 章のほか、各フレームワークの公式チュートリアルを参照してください。
11.4 演習問題
演習 11-1: 生の画素値による分類
演習 11-1
MNIST サブセット(1,000 枚)の生の画素値を、ロジスティック回帰で分類してください。
タスク:
- MNIST サブセット(1,000 枚)を読み込む
- 訓練 80%・テスト 20% に分割(
random_state=42,stratify=y)し、画素値を 0〜1 に正規化する LogisticRegression(max_iter=1000, random_state=42)で学習し、テスト精度を表示する
データセット: data/mnist_1000_raw.npz
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

# 1. データの読み込み
data = np.load('mnist_1000_raw.npz')
X = data['X']  # (1000, 784)
y = data['y']  # (1000,)

# 2. 訓練・テストに分割し、画素値を 0〜1 に正規化

# 3. ロジスティック回帰で学習し、テスト精度を表示
解答例
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

# 1. データの読み込み
data = np.load('mnist_1000_raw.npz')
X = data['X']  # (1000, 784)
y = data['y']  # (1000,)

# 2. 訓練・テストに分割し、画素値を 0〜1 に正規化
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)
X_train = X_train / 255.0
X_test = X_test / 255.0

# 3. ロジスティック回帰で学習・評価
model = LogisticRegression(max_iter=1000, random_state=42)
model.fit(X_train, y_train)
acc_pixel = accuracy_score(y_test, model.predict(X_test))
print(f"生の画素値による分類精度: {acc_pixel:.4f}")
考察:生の画素値をそのまま入力しても、精度は 85% になりました。ロジスティック回帰は 784 個の画素すべての重み付き和で判断するので、1 つの画素のしきい値で分岐する決定木(本文では 500 枚で約 60%)より高い精度が出ます。ただし、生の画素値は数字の位置がずれたり形が崩れたりすると弱くなります。演習 11-2 では、HOG 特徴量でこの点を改善します。
演習 11-2: HOG 特徴量による分類
演習 11-2
MNIST サブセット(1,000 枚)から HOG 特徴量を抽出し、ロジスティック回帰で分類してください。
タスク:
- MNIST サブセット(1,000 枚)を読み込み、演習 11-1 と同じ分割・正規化を行う
- 訓練・テストそれぞれの画像から HOG 特徴量を抽出する(
orientations=9,pixels_per_cell=(4, 4),cells_per_block=(2, 2)) LogisticRegression(max_iter=1000, random_state=42)で学習し、テスト精度を表示する- 演習 11-1 と同じ訓練・テスト分割で、生の画素値を使った場合と精度がどう変わるかを確認する
データセット: data/mnist_1000_raw.npz
import numpy as np
from skimage.feature import hog
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

# 1. データの読み込みと分割・正規化(演習 11-1 と同じ)
data = np.load('mnist_1000_raw.npz')
X = data['X']
y = data['y']

# 2. HOG 特徴量の抽出

# 3. ロジスティック回帰で学習・精度を表示

# 4. 演習 11-1 の結果と比較
解答例
import numpy as np
from skimage.feature import hog
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

# 1. データの読み込みと分割・正規化(演習 11-1 と同じ)
data = np.load('mnist_1000_raw.npz')
X = data['X']
y = data['y']
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)
X_train = X_train / 255.0
X_test = X_test / 255.0

# 2. HOG 特徴量の抽出
def extract_hog_features(images):
    """画像配列から HOG 特徴量を抽出する"""
    hog_features = []
    for img in images:
        feature = hog(
            img.reshape(28, 28),
            orientations=9,
            pixels_per_cell=(4, 4),
            cells_per_block=(2, 2),
            block_norm="L2-Hys",
            feature_vector=True
        )
        hog_features.append(feature)
    return np.array(hog_features)

X_train_hog = extract_hog_features(X_train)
X_test_hog = extract_hog_features(X_test)
print(f"HOG特徴量の次元数: {X_train_hog.shape[1]}")

# 3. ロジスティック回帰で学習・評価
model_hog = LogisticRegression(max_iter=1000, random_state=42)
model_hog.fit(X_train_hog, y_train)
acc_hog = accuracy_score(y_test, model_hog.predict(X_test_hog))
print(f"HOG特徴量による分類精度: {acc_hog:.4f}")

# 4. 演習 11-1(生の画素値: 0.8500)との比較
diff = acc_hog - 0.8500
print(f"精度の改善: {diff:.4f} ({diff * 100:.2f}ポイント)")
考察:精度は生の画素値の 85.0% から、HOG 特徴量で 94.5% に上がりました(9.5 ポイントの改善)。HOG 特徴量は局所的なエッジの方向と強さ、つまり数字の線の向きを表すので、画素の明暗を並べただけの値より数字を見分けやすくなります。次元数は 784 から 1296 に増えていますが、精度が上がったのは次元が増えたからではなく、形の情報を取り出したためです。
演習 11-3: HOG パラメータの調整
演習 11-3
HOG 特徴量の設定を変えて、特徴量の次元数と分類精度がどのように変化するか確認してください。
タスク:
- 演習 11-2 と同じデータ・分割を使う
pixels_per_cell=(7, 7)(orientations=9)に変更した場合の次元数とテスト精度を求めるorientations=4(pixels_per_cell=(4, 4))に変更した場合の次元数とテスト精度を求める- 演習 11-2 の基準設定(
pixels_per_cell=(4, 4),orientations=9)の結果と比較し、考察する
解答例
import numpy as np
from skimage.feature import hog
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

# 演習 11-2 と同じデータ・分割
data = np.load('mnist_1000_raw.npz')
X = data['X']
y = data['y']
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)
X_train = X_train / 255.0
X_test = X_test / 255.0

def extract_hog_features(images, orientations=9, ppc=(4, 4)):
    """パラメータを変えられるHOG特徴量抽出関数"""
    feats = []
    for img in images:
        feats.append(hog(
            img.reshape(28, 28), orientations=orientations,
            pixels_per_cell=ppc, cells_per_block=(2, 2),
            block_norm="L2-Hys", feature_vector=True))
    return np.array(feats)

def evaluate(X_tr, X_te, label):
    model = LogisticRegression(max_iter=1000, random_state=42)
    model.fit(X_tr, y_train)
    acc = accuracy_score(y_test, model.predict(X_te))
    print(f"{label}: 次元数 {X_tr.shape[1]}, テスト精度 {acc:.4f}")

# 演習 11-2 の設定(基準)
evaluate(extract_hog_features(X_train),
         extract_hog_features(X_test), "基準 ppc=(4,4), ori=9")

# pixels_per_cell を (7, 7) に変更
evaluate(extract_hog_features(X_train, ppc=(7, 7)),
         extract_hog_features(X_test, ppc=(7, 7)), "ppc=(7,7), ori=9")

# orientations を 4 に変更
evaluate(extract_hog_features(X_train, orientations=4),
         extract_hog_features(X_test, orientations=4), "ppc=(4,4), ori=4")
基準 ppc=(4,4), ori=9: 次元数 1296, テスト精度 0.9450
ppc=(7,7), ori=9: 次元数 324, テスト精度 0.9200
ppc=(4,4), ori=4: 次元数 576, テスト精度 0.9450
考察:pixels_per_cell を (7, 7) にすると、次元数は 1296 から 324 に減り、精度は 94.5% から 92.0% に下がりました。セルが粗くなり、細かい線の情報が失われたためです。orientations を 4 にした場合は、次元数が 576 に減っても精度は 94.5% のままでした。この例では、勾配方向の細かさよりも、エッジの位置をどれだけ細かく見るかのほうが精度に効いています。次元数は計算コストに直結するので、精度と見比べて設定を選びます。
演習 11-4: 同一特徴量でのモデル比較
演習 11-4
演習 11-2 と同じ HOG 特徴量に対して、3 つのモデルで分類精度を比較してください。
タスク:
- 演習 11-2 と同じデータ・分割・HOG 特徴量を使う
- 以下の 3 モデルでテスト精度を計算する
- 結果を一覧表示し、どのモデルが HOG 特徴量と相性が良いか考察する
解答例
import numpy as np
from skimage.feature import hog
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

# 演習 11-2 と同じデータ・分割
data = np.load('mnist_1000_raw.npz')
X = data['X']
y = data['y']
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)
X_train = X_train / 255.0
X_test = X_test / 255.0

# 演習 11-2 と同じ設定で HOG 特徴量を抽出
def extract_hog_features(images):
    feats = []
    for img in images:
        feats.append(hog(
            img.reshape(28, 28), orientations=9,
            pixels_per_cell=(4, 4), cells_per_block=(2, 2),
            block_norm="L2-Hys", feature_vector=True))
    return np.array(feats)

X_train_hog = extract_hog_features(X_train)
X_test_hog = extract_hog_features(X_test)

# 3 つのモデルで学習・評価
models = {
    "決定木": DecisionTreeClassifier(random_state=42),
    "ロジスティック回帰": LogisticRegression(
        max_iter=1000, random_state=42),
    "ランダムフォレスト": RandomForestClassifier(
        n_estimators=100, random_state=42),
}
for name, model in models.items():
    model.fit(X_train_hog, y_train)
    acc = accuracy_score(y_test, model.predict(X_test_hog))
    print(f"{name}: テスト精度 {acc:.4f}")
考察:同じ HOG 特徴量でも、決定木 71.0%、ランダムフォレスト 91.5%、ロジスティック回帰 94.5% と大きな差が出ました。決定木は 1 回の分岐で 1 つの特徴量しか見ないため、1296 次元に散らばったエッジの情報をうまく組み合わせられません。ランダムフォレストは多数の木の多数決で大きく改善しますが、すべての特徴量の重み付き和で判断するロジスティック回帰には届きませんでした。アンサンブルがいつも最良になるわけではなく、特徴量に合ったモデルを選ぶ必要があります。
演習 11-5: CIFAR-10 のカラー画像分類
演習 11-5
カラー画像のベンチマーク CIFAR-10 のサブセット(1,000 枚)に対して、本章と同じ手順の画像分類を適用し、手書き数字との違いを確認してください。
タスク:
- CIFAR-10 サブセット(1,000 枚)を読み込む
- 生の画素値(カラーのまま平坦化し 0〜1 に正規化)を訓練 80%・テスト 20% に分割(
random_state=42,stratify=y)し、ロジスティック回帰で分類してテスト精度を求める - グレースケール変換後に HOG 特徴量(
orientations=9,pixels_per_cell=(4, 4),cells_per_block=(2, 2))を抽出し、同様に分類してテスト精度を求める - MNIST の結果(演習 11-1・11-2)と比較し、精度が変わる理由を考察する
ヒント:画像は32×32です。生の画素値は X.reshape(len(X), -1) で1次元化し、HOGには rgb2gray() 関数で得た32×32の画像をそのまま渡します(28×28への変形は不要です)。両手法の比較には同じ元画像の訓練・テスト分割を使います。
発展として、11.2 節で学んだ RGB ヒストグラム特徴量を組み合わせ、色の情報がどの程度効くかを確かめるのも良いでしょう。
データセット: data/cifar_1000_color.npz
import numpy as np
from skimage.color import rgb2gray
from skimage.feature import hog
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

# 1. データの読み込み
data = np.load('cifar_1000_color.npz')
X = data['X']  # (1000, 32, 32, 3)
y = data['y']  # (1000,)

# グレースケール変換の例
X_gray = np.array([rgb2gray(img) for img in X])

# 2. 生の画素値による分類

# 3. グレースケール → HOG 特徴量による分類

# 4. 結果の比較
解答例
import numpy as np
from skimage.color import rgb2gray
from skimage.feature import hog
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

# 1. CIFAR-10 サブセットの読み込み
data = np.load('cifar_1000_color.npz')
X, y = data['X'], data['y']  # X: (1000, 32, 32, 3)

# 2. 生の画素値(カラーのまま平坦化、0〜1に正規化)
X_flat = X.reshape(len(X), -1) / 255.0
X_train, X_test, y_train, y_test = train_test_split(
    X_flat, y, test_size=0.2, random_state=42, stratify=y
)
model = LogisticRegression(max_iter=1000, random_state=42)
model.fit(X_train, y_train)
acc_pixel = accuracy_score(y_test, model.predict(X_test))
print(f"生の画素値による分類精度: {acc_pixel:.4f}")

# 3. グレースケール変換 → HOG特徴量
X_gray = np.array([rgb2gray(img) for img in X])
X_hog = np.array([
    hog(img, orientations=9, pixels_per_cell=(4, 4),
        cells_per_block=(2, 2), block_norm="L2-Hys",
        feature_vector=True)
    for img in X_gray
])
Xh_train, Xh_test, yh_train, yh_test = train_test_split(
    X_hog, y, test_size=0.2, random_state=42, stratify=y
)
model_hog = LogisticRegression(max_iter=1000, random_state=42)
model_hog.fit(Xh_train, yh_train)
acc_hog = accuracy_score(yh_test, model_hog.predict(Xh_test))
print(f"HOG特徴量の次元数: {X_hog.shape[1]}")
print(f"HOG特徴量による分類精度: {acc_hog:.4f}")
考察:CIFAR-10 の精度は、生の画素値で 30.5%、HOG 特徴量で 42.5% でした。手書き数字(85.0%、94.5%)よりかなり低いものの、10 クラスをランダムに予測した場合の 10% よりは高く、学習はできています。手書き数字は白い背景に黒い線で書かれ、同じ数字なら画素の並びも似ています。CIFAR-10 は実際の写真で、同じ「犬」でも犬種や向き、背景、明るさがばらばらです。そのため HOG 特徴量で 12.0 ポイント上がっても、まだ十分な精度にはなりません。このような画像には、特徴量そのものをデータから学習する CNN(第14章)が向いています。
課題 11
課題 11: CIFAR-10 のカラー画像分類
CIFAR-10 の画像を分類するモデルを 2 つ以上実装し、精度について比較・考察してください。
※ 加点要素
- 3 つ以上の改善を試す(特徴量 + モデルの両方を工夫)
- サブセットサイズ(500 → 1000 → 2000)を変えたときの精度の伸びを確認する
- 誤分類された画像を可視化し、どのようなクラスが混同されやすいかを分析する
提出物:
- Word ファイルで作成し、PDF 形式で出力して提出(学生番号_氏名_11.pdf)
- 問題文・ソースコード・結果・考察を PDF 内に含めること(参考:
機械学習_レポートサンプル.docx)
提出期限: 2026年6月28日(日)23:59
提出先: manaba
CIFAR-10 サブセット(データセット)
- 500サンプル: data/cifar_500_color.npz
- 1000サンプル: data/cifar_1000_color.npz
- 2000サンプル: data/cifar_2000_color.npz
ヒント①:カラー画像での HOG 特徴量
OpenCV や skimage.color.rgb2gray() 関数でカラー画像をグレースケールに変換し、第 10 章で学んだ HOG 特徴量を抽出できます。
import numpy as np
from skimage.feature import hog
from skimage.color import rgb2gray
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

data = np.load('cifar_500_color.npz')
X = data['X']
y = data['y']

# HOG 特徴量(グレースケールに変換してから抽出)
X_hog = np.array([
    hog(rgb2gray(img), orientations=9,
        pixels_per_cell=(4, 4), cells_per_block=(2, 2))
    for img in X
])
print(f"HOG 特徴量の次元: {X_hog.shape[1]}")

X_train, X_test, y_train, y_test = train_test_split(
    X_hog, y, test_size=0.2, random_state=42, stratify=y
)
model = LogisticRegression(max_iter=2000, random_state=42)
model.fit(X_train, y_train)
print(f"HOG + LogReg 精度: {accuracy_score(y_test, model.predict(X_test)):.4f}")
ヒント②:複数特徴量の組み合わせ
RGB ヒストグラムと HOG を numpy.concatenate() 関数で連結すれば、色情報と形状情報の両方を持つ特徴量になります。
# 1 画像から 「RGB ヒスト + HOG」を連結した特徴ベクトル
def extract_combined(image):
    hist_feats = []
    for ch in range(3):
        h, _ = np.histogram(image[:, :, ch], bins=32, range=(0, 256))
        hist_feats.append(h)
    hist_concat = np.concatenate(hist_feats)
    hog_feat = hog(rgb2gray(image), orientations=9,
                   pixels_per_cell=(4, 4), cells_per_block=(2, 2))
    return np.concatenate([hist_concat, hog_feat])
まとめ
本章では、生の画素値・HOG 特徴量・RGB ヒストグラム特徴量を用いた画像分類の実践と、CNN の概要について学びました。
第 11 章のまとめ
画像分類の基礎
- 画像を見てカテゴリを判定するタスク
- 特徴抽出 → 機械学習 → 予測
生の画素値を用いた画像分類(MNIST)
- 特徴抽出なしで決定木に与えると約 60% の精度
- 高次元の画像データには決定木が向かないことを示すベースライン
HOG 特徴量を用いた画像分類(MNIST)
- エッジの方向のヒストグラムで画像の重要な情報を 324 次元に圧縮
- 決定木では 56% にとどまる(特徴量が良くてもモデルが活かせなければ無意味)
RGB ヒストグラム特徴量を用いた画像分類(CIFAR-10)
- 第 10 章演習 10-6 の RGB ヒストグラムを画像分類の特徴量として活用
- 96 次元の低次元特徴量だが、決定木では約 19% にとどまる
- 空間情報を捨てるため複雑なカラー画像では限界が見える
古典的手法の利点と限界
- 利点: 比較的少ないデータでも試しやすく、設計した特徴を確認しやすい
- 限界: 人間が特徴量を設計する必要がある、色 + 形 + 空間配置を統合した特徴量は設計困難
CNN の紹介
- データから自動的に特徴量を学習
- 精度はデータ・モデル・学習条件に依存し、古典的手法とは同じ評価条件で比較する
- 大量のデータと計算資源が必要
- 現代の画像認識の中心的手法