6. 回帰

本章では、数値を予測する回帰モデルを扱います。単回帰と重回帰から始め、多項式回帰、正則化、評価指標の順に、学習と評価の手順を確認します。
NumPyに加えて、表形式データを扱う pandas(パンダス) を使用します。CSVの読み込み、列の選択、集計など、回帰分析の前後で必要になる操作をDataFrameで行います(pandasの基礎は第2章を参照してください)。
6.1 単回帰
6.1.1 単回帰分析
線形回帰(Linear Regression) は、最もシンプルな機械学習アルゴリズムの一つで、データを直線で近似するモデルです。
1 つの特徴量 \(x\) からラベル \(y\) を予測する場合、線形回帰モデルは以下のように表されます。
ここで、\(a\) は傾き、\(b\) は切片です。機械学習では、これらのパラメータをデータから自動的に学習します。
graph LR
    A("特徴量 x<br/>勉強時間") --> B("線形回帰モデル<br/>y = ax + b")
    B --> C("ラベル y<br/>試験の点数")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    class A data
    class B model
class C outこのように、1 つの特徴量から予測を行う回帰分析を単回帰分析(Simple Linear Regression) と呼びます。
6.1.2 簡単なデータでの実践
以下は、簡単なデータを使って線形回帰を実践する例です。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression

# サンプルデータの作成(勉強時間と試験の点数)
# X: 勉強時間(時間)、y: 試験の点数(点)
X = np.array([[1], [2], [3], [4], [5], [6], [7], [8]])
y = np.array([45, 55, 60, 65, 70, 75, 80, 85])

# 線形回帰モデルの作成
model = LinearRegression()

# モデルの学習
model.fit(X, y)

# 学習したパラメータの確認
print(f"傾き: {model.coef_[0]:.2f}")
print(f"切片: {model.intercept_:.2f}")

# 予測
X_new = np.array([[9], [10]])  # 新しいデータ
y_pred = model.predict(X_new)
print(f"勉強時間 9 時間の予測点数: {y_pred[0]:.2f}")
print(f"勉強時間 10 時間の予測点数: {y_pred[1]:.2f}")

# 可視化
plt.scatter(X, y, color='blue', label='Training Data')
plt.plot(X, model.predict(X), color='red', label='Regression Line')
plt.scatter(X_new, y_pred, color='green', marker='x', s=100, label='Prediction')
plt.xlabel('Study Hours')
plt.ylabel('Test Score')
plt.legend()
plt.grid(True)
plt.show()
このコードを実行すると、勉強時間と試験の点数の関係を表す直線が描かれ、新しいデータに対する予測も行われます。
書籍の入力6.1 の ravel() について
書籍の入力6.1 では、データを次のように作っています。
X = np.arange(1, 21).reshape(-1, 1).astype(float)
y = 3.5 * X.ravel() + 30 + np.random.randn(20) * 5
X は scikit-learn に渡すために reshape(-1, 1) で「20 行 1 列」の 2 次元配列にしてあります。一方、y は 1 次元配列(要素数 20)にしたいので、X.ravel() メソッドで 2 次元配列を 1 次元に平坦化してから計算しています。ravel() メソッドを使わずに 3.5 * X + 30 + np.random.randn(20) * 5 と書くと、「20 行 1 列」と「要素数 20」の組み合わせがブロードキャストされて 20 × 20 の 2 次元配列になってしまい、意図した y になりません。X.ravel() メソッドの代わりに X[:, 0] や X.flatten() メソッドと書いても同じ結果になります。
単回帰分析の利点
単回帰分析は非常にシンプルなモデルですが、以下のような利点があります:
- 計算が高速で、大規模データにも対応できる
- 結果が解釈しやすい(傾きと切片の意味が明確)
- 実装が簡単
- 可視化が容易(2次元グラフで表現できる)
複雑なデータには向きませんが、まず最初に試すべき基本的なモデルです。
6.1.3 NumPy を使った実装
まずは、NumPy の配列を使った実装を見ていきましょう。
データを訓練データとテストデータに分割するためには、sklearn.model_selection.train_test_split() 関数を使用します。
線形回帰モデルを作成するためには、sklearn.linear_model.LinearRegression クラスを使用します。モデルを学習するには .fit() メソッド、予測を行うには .predict() メソッドを使用します。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

# サンプルデータの作成(広告費と売上の関係)
# X: 広告費(万円)、y: 売上(万円)
X = np.array([[5], [10], [15], [20], [25], [30], [35], [40], [45], [50]])
y = np.array([15, 28, 35, 48, 55, 62, 70, 80, 88, 95])

# データを訓練データとテストデータに分割(8:2)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 線形回帰モデルの作成と学習
model = LinearRegression()
model.fit(X_train, y_train)

# テストデータで予測
y_pred = model.predict(X_test)

# 可視化
plt.scatter(X_train, y_train, color='blue', s=100, label='訓練データ', alpha=0.6)
plt.scatter(X_test, y_test, color='green', s=100, label='テストデータ', alpha=0.6)
plt.plot(X, model.predict(X), color='red', label='回帰直線')
plt.xlabel('広告費(万円)')
plt.ylabel('売上(万円)')
plt.title('単回帰分析(広告費 vs 売上)')
plt.legend()
plt.grid(alpha=0.3)
plt.show()
6.1.4 pandas を使った実装
次に、pandas の DataFrame を使った実装例です。実際のデータ分析では、pandas を使うことが多いです。
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

# pandas DataFrame でデータを作成
data = pd.DataFrame({
    '広告費': [5, 10, 15, 20, 25, 30, 35, 40, 45, 50],
    '売上': [15, 28, 35, 48, 55, 62, 70, 80, 88, 95]
})

# 特徴量とラベルを分離
X = data[['広告費']]  # DataFrame として保持
y = data['売上']      # Series として保持

# データを訓練データとテストデータに分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# モデルの学習
model = LinearRegression()
model.fit(X_train, y_train)

# 予測
y_pred = model.predict(X_test)

# 可視化
plt.scatter(X_train, y_train, color='blue', s=100, label='訓練データ', alpha=0.6)
plt.scatter(X_test, y_test, color='green', s=100, label='テストデータ', alpha=0.6)
plt.plot(X, model.predict(X), color='red', label='回帰直線')
plt.xlabel('広告費(万円)')
plt.ylabel('売上(万円)')
plt.title('単回帰分析(広告費 vs 売上)')
plt.legend()
plt.grid(alpha=0.3)
plt.show()
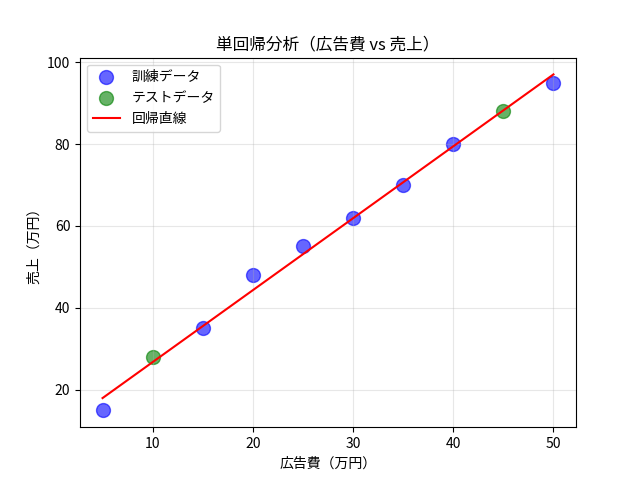
上記コードの結果は NumPy を使った場合も pandas を使った場合も全く同じで、以下の画像が出力されます。
機械学習における実装の違い
NumPy 配列での実装
- コード例:
X = np.array([[5], [10], [15]]) - 2次元配列として明示的に形状を指定する必要がある
- シンプルで高速な数値計算に適している
pandas での実装
- コード例:
X = df[['広告費']] - 列名で指定できるため、コードの可読性が高い
- データの前処理(欠損値処理、統計情報確認など)が容易
どちらの方法でも scikit-learn の機械学習モデルは同じように動作します。実務では pandas を使うことが多いですが、両方使えるようになっておきましょう(pandas と NumPy の相互変換の詳細は 第 2 章 を参照)。
Playground:単回帰
単回帰 の Playground では、傾き \(a\) と切片 \(b\) のスライダーを手で動かして、データ点に一番合う直線を探せます。直線を動かすたびに残差平方和と決定係数 \(R^2\) が変わるので、残差が小さいほど \(R^2\) が 1 に近づくことを体感してから、「最小二乗法で自動フィット」で答え合わせをしてみましょう。
6.2 重回帰
6.2.1 重回帰分析とは
重回帰分析(Multiple Linear Regression) は、複数の特徴量を使って予測を行う回帰分析です。
ここで、\(w_1, w_2, \ldots, w_n\) は各特徴量の重み(係数)、\(b\) は切片です。
graph LR
    A1("x1: 面積") --> B("重回帰モデル<br/>y = w1·x1 + w2·x2 + w3·x3 + b")
    A2("x2: 築年数") --> B
    A3("x3: 駅距離") --> B
    B --> C("y: 価格")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    class A1,A2,A3 data
    class B model
    class C out
6.2.2 重回帰分析の実装
pandas を使用した重回帰分析の実装例は以下のようになります。基本的な流れは単回帰分析を変わりません。
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression

# データ作成
data = pd.DataFrame({
    '面積': [60, 80, 100, 50, 70, 90, 55, 85, 75, 95],
    '築年数': [15, 5, 2, 20, 10, 3, 18, 7, 12, 4],
    '価格': [3200, 4500, 5800, 2800, 3800, 5200, 2900, 4300, 3900, 5400]
})

# モデル学習
X = data[['面積', '築年数']]
y = data['価格']
model = LinearRegression().fit(X, y)

# 結果表示
print(f"予測式: 価格 = {model.intercept_:.1f} + {model.coef_[0]:.1f} × 面積 + {model.coef_[1]:.1f} × 築年数")

# 可視化
y_pred = model.predict(X)
plt.scatter(y, y_pred, s=100, alpha=0.6)
plt.plot([y.min(), y.max()], [y.min(), y.max()], color='red', label='理想的な予測')
plt.xlabel('実測値(万円)')
plt.ylabel('予測値(万円)')
plt.title('住宅価格予測')
plt.legend()
plt.grid(alpha=0.3)
plt.show()
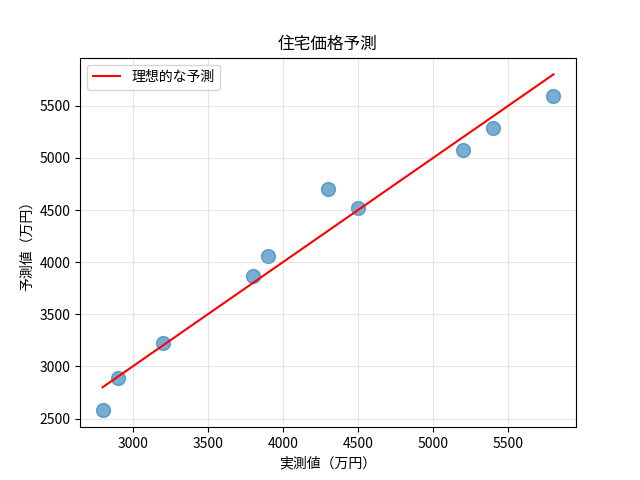
係数の解釈
学習された係数から、以下のような解釈ができます。
- 面積の係数が正 → 築年数が同じなら、面積が広いほど予測価格が高くなる
- 築年数の係数が負 → 面積が同じなら、築年数が増えるほど予測価格が下がる
係数は、その特徴量が1単位増えたときの予測価格の変化を表します。特徴量の単位が異なるため、係数の絶対値だけでは重要度を比較できません。
Playground:重回帰
重回帰 の Playground では、説明変数が 2 つになると予測が直線ではなく 平面 になることを 3D で確かめられます。\(w_1\)・\(w_2\)・\(b\) のスライダーで平面を傾けて点群の真ん中を通るように合わせ、グラフをドラッグして視点を回しながら、各点から平面までの残差(赤い縦線)が縮む様子を見てみましょう。
6.3 多項式回帰
6.3.1 多項式回帰とは
線形回帰モデルでは直線でしか近似できませんが、多項式回帰(Polynomial Regression) を使うことで、曲線的な関係も表現できます。
例えば、2 次の多項式回帰は以下のように表されます:
graph LR
    A("元の特徴量<br/>x") --> B("多項式特徴量生成<br/>x, x²")
    B --> C("線形回帰<br/>y = w1·x + w2·x² + b")
    C --> D("予測値 y")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    class A data
    class B proc
    class C model
    class D out
6.3.2 多項式回帰の実装例
多項式特徴量を生成するためには、sklearn.preprocessing.PolynomialFeatures クラスを使用します。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
from sklearn.metrics import r2_score

# 非線形データ生成(曲線的なデータ)
np.random.seed(42)
X = np.sort(np.random.rand(50, 1) * 10, axis=0)
y = 0.5 * X.squeeze() ** 2 - 3 * X.squeeze() + 20 + np.random.randn(50) * 5

# 異なる次数で多項式回帰
degrees = [1, 2, 3, 5]
fig, axes = plt.subplots(2, 2, figsize=(12, 9))
axes = axes.ravel()

for i, degree in enumerate(degrees):
    # 多項式変換して学習
    poly = PolynomialFeatures(degree=degree)
    X_poly = poly.fit_transform(X)
    model = LinearRegression().fit(X_poly, y)

    # 予測曲線の生成
    X_plot = np.linspace(0, 10, 100).reshape(-1, 1)
    y_plot = model.predict(poly.transform(X_plot))

    # R²の計算
    r2 = r2_score(y, model.predict(X_poly))

    # グラフ描画
    axes[i].scatter(X, y, alpha=0.6, s=50)
    axes[i].plot(X_plot, y_plot, 'r-', linewidth=2)
    axes[i].set_title(f'{degree}次多項式 (R² = {r2:.3f})')
    axes[i].grid(alpha=0.3)

plt.tight_layout()
plt.show()

# 結果比較
print("次数  R²")
print("-" * 15)
for degree in degrees:
    poly = PolynomialFeatures(degree=degree)
    X_poly = poly.fit_transform(X)
    model = LinearRegression().fit(X_poly, y)
    r2 = r2_score(y, model.predict(X_poly))
    print(f"{degree}次:  {r2:.4f}")
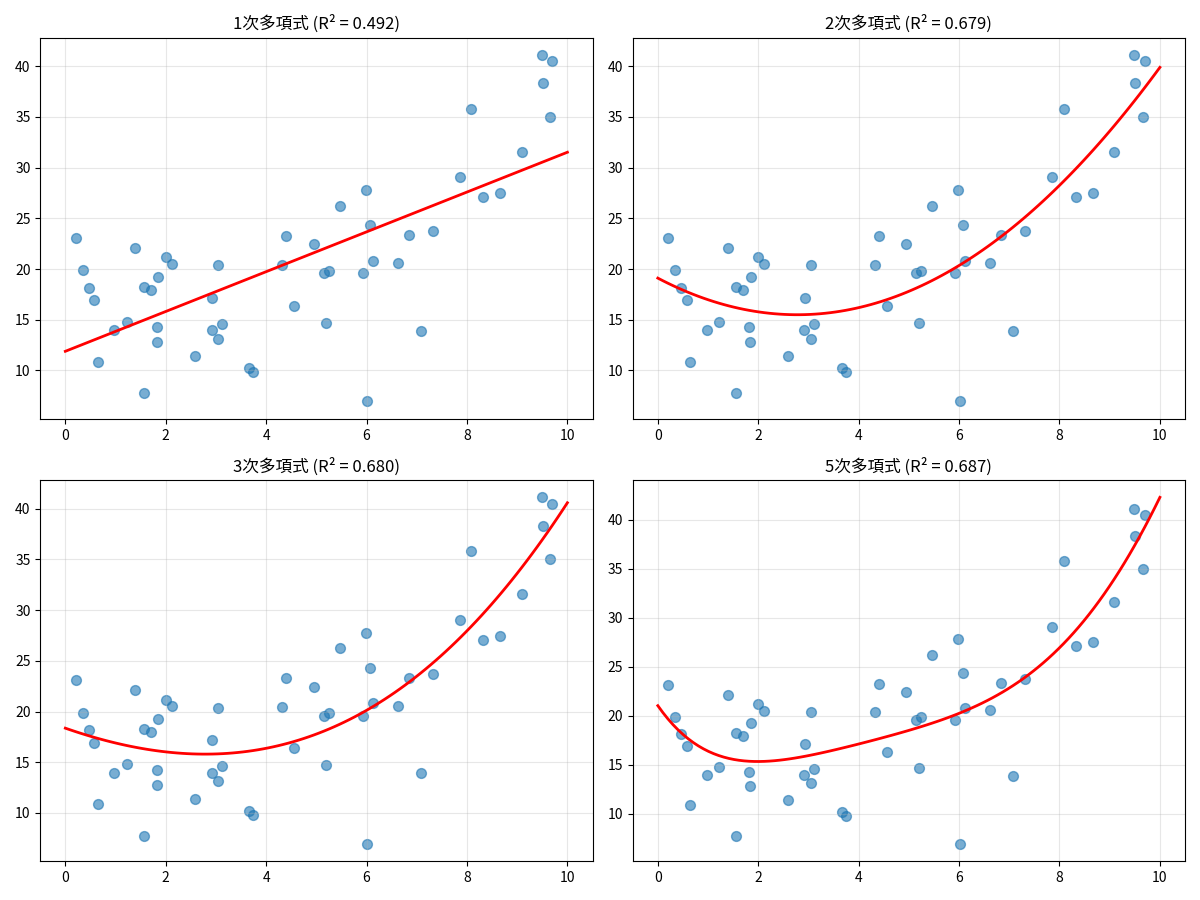
多項式回帰の注意点
次数を上げすぎると、過学習が発生しやすくなります。
- 次数が低すぎる:モデルがデータの複雑さを捉えられない(未学習)
- 次数が適切:データのパターンをうまく捉えられる
- 次数が高すぎる:訓練データに過度に適合し、新しいデータでの性能が悪化(過学習)
適切な次数は、訓練データの中で交差検証(第5章)を行って選びます。
Playground:多項式回帰
多項式回帰 の Playground では、次数 \(d\) のスライダーを動かすと曲線の形と訓練誤差 MSE が同時に変わります。次数を上げるほど MSE は下がり続けますが、曲線がぐにゃぐにゃ波打ってノイズまで覚えてしまう過学習の状態を、目で見て確かめてみましょう。
6.4 正則化(リッジ回帰、ラッソ回帰)
線形回帰の過学習を抑える手法として 正則化(Regularization) があります。多くの実務で使われる重要な技術ですが、本講義では概要のみ紹介します。詳しく学びたい人は、以下の折りたたみの中に目を通してみてください。
正則化(Ridge 回帰・Lasso 回帰)の詳細
正則化(Regularization) は、過学習を防ぐための手法です。モデルの係数が大きくなりすぎないように制約を加えます。
graph TB
    A("線形回帰モデル") --> B("通常の線形回帰<br/>LinearRegression")
    A --> C("Ridge回帰<br/>L2正則化")
    A --> D("Lasso回帰<br/>L1正則化")
    A --> E("ElasticNet<br/>L1+L2正則化")

    B --> B1("係数に制約なし<br/>過学習しやすい")
    C --> C1("係数を小さく抑える<br/>すべての特徴量を使用")
    D --> D1("不要な特徴量の係数を0に<br/>特徴量選択の効果")
    E --> E1("RidgeとLassoの両方の性質")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    classDef neu fill:#F2F2F2,stroke:#8C8C8C,stroke-width:2px,color:#000
    class A neu
    class B,B1 data
    class C,C1 proc
    class D,D1 model
    class E,E1 out
Ridge 回帰
L2 正則化を使った線形回帰です。係数の二乗和を小さく抑えます。
ここで、\(\alpha\) は正則化の強さを制御するハイパーパラメータです。
Ridge 回帰を実装するためには、sklearn.linear_model.Ridge クラスを使用します。
Lasso 回帰
L1 正則化を使った線形回帰です。不要な特徴量の係数を 0 にする効果があります。
scikit-learn の Lasso クラスは二乗誤差の合計を \(2n\) で割った目的関数を使うため、上の式と同じ \(\alpha\) を指定しても正則化の強さは異なります。
Lasso 回帰を実装するためには、sklearn.linear_model.Lasso クラスを使用します。
Ridge と Lasso の比較
Ridge 回帰
- すべての特徴量を使用する(係数は小さくなるが0にはならない)
- 多重共線性に強い
- 予測精度を重視する場合に使用
Lasso 回帰
- 不要な特徴量の係数を0にする(自動的に特徴量選択)
- 解釈性を重視する場合に使用
- 特徴量が多い場合に有効
どちらを使うべきか
- 特徴量が多く、重要なものを選びたい → Lasso
- すべての特徴量が重要だが、過学習を防ぎたい → Ridge
- 両方の性質が欲しい → ElasticNet(Ridge + Lasso)
Playground:Ridge 回帰と Lasso 回帰
正則化の効き方は 正則化パス(\(\alpha\) を変えたときに各係数がどう動くかを描いた図)で見るとよく分かります。Ridge 回帰 では \(\alpha\) を強めると係数がなめらかに 0 へ縮む一方、完全な 0 にはなりにくいこと、そして訓練 RMSE と引き換えにテスト RMSE が途中で最小になることを確認できます。Lasso 回帰 では、影響の小さい特徴量から順に係数がちょうど 0 に張り付いていく(=自動的な特徴量選択)様子を追えます。両者の中間として ElasticNet 回帰 では L1 比率 \(\rho\) を動かし、Ridge 寄りと Lasso 寄りの振る舞いを連続的に比べられます。
6.5 回帰モデルの評価指標
6.5.1 回帰問題の評価指標
回帰問題では、主に以下の評価指標が使用されます。
graph TB
    A("回帰モデルの評価指標") --> B("MSE<br/>平均二乗誤差")
    A --> C("RMSE<br/>平均二乗平方根誤差")
    A --> D("MAE<br/>平均絶対誤差")
    A --> E("R²<br/>決定係数")

    B --> B1("単位: 元の値の二乗<br/>大きな誤差に敏感")
    C --> C1("単位: 元の値と同じ<br/>最も一般的")
    D --> D1("単位: 元の値と同じ<br/>外れ値に強い")
    E --> E1("範囲: -∞~1<br/>モデルの説明力")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    classDef neu fill:#F2F2F2,stroke:#8C8C8C,stroke-width:2px,color:#000
    class A neu
    class B,B1 data
    class C,C1 proc
    class D,D1 model
    class E,E1 out
6.5.2 MSE(平均二乗誤差)
平均二乗誤差(Mean Squared Error) は、予測値と実際の値の差の二乗の平均です。
特徴
- 値が小さいほど良い
- 大きな誤差を重視する(二乗しているため)
- 単位が元の値の二乗になる
6.5.3 RMSE(平均二乗平方根誤差)
平均二乗平方根誤差(Root Mean Squared Error) は、MSE の平方根です。
特徴
- 値が小さいほど良い
- 元のデータと同じ単位(解釈しやすい)
- 最も一般的に使われる指標
6.5.4 MAE(平均絶対誤差)
平均絶対誤差(Mean Absolute Error) は、予測値と実際の値の差の絶対値の平均です。
特徴
- 値が小さいほど良い
- 外れ値の影響を受けにくい
- すべての誤差を均等に扱う
6.5.5 R²(決定係数)
決定係数(R-squared) は、モデルがデータの変動をどれだけ説明できているかを示します。
特徴
- 範囲は通常 0 から 1(負の値もあり得る)
- 1 に近いほど良い
- モデルの説明力を示す最も一般的な指標
R² の解釈
- R² = 0.9: 非常に良い(データの90%を説明)
- R² = 0.7: まあまあ良い(データの70%を説明)
- R² = 0.5: 改善の余地あり(データの50%を説明)
- R² = 0.1: モデルを見直すべき(データの10%しか説明できていない)
6.5.6 評価指標の実装
評価指標を計算するためには、scikit-learn の metrics モジュールを使用します。MSE を計算するには sklearn.metrics.mean_squared_error() 関数、R² を計算するには sklearn.metrics.r2_score() 関数を使用します。
model.score() と r2_score() の関係
第 4 章で学んだ model.score(X, y) は、LinearRegression クラスの場合は内部で R² を計算しており、r2_score(y_true, model.predict(X)) と等価です。
本講義では、MSE / RMSE / MAE と書き方を揃えて分かりやすくするため、r2_score(y_true, y_pred) の形に統一して使います。
なお、R² は「訓練データ」と「テストデータ」の両方で計算するのが基本です。第 4 章で触れた 過学習(Overfitting)(モデルが訓練データに合わせ込みすぎて未知のデータでは性能が落ちる現象)は、両者の指標を比較することで検出できます。
- 訓練 R² ≫ テスト R²:訓練データだけで高精度 → 過学習している
- 訓練 R² ≈ テスト R²:未知データでも同程度の性能 → うまく汎化できている
- 訓練 R² も テスト R² も低い:モデルの表現力が不足 → 未学習(Underfitting)
下のコードでは、訓練 R² とテスト R² の差で過学習の度合いを 3 段階に分類しています。差のしきい値(0.05 / 0.15)はこの例の仮の目安です。差だけで良否を決めず、訓練・テストそれぞれの R² の水準も確認します。
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score

# サンプルデータ作成
np.random.seed(42)
X = np.random.rand(100, 3) * 10
y = 2 * X[:, 0] + 3 * X[:, 1] - 1.5 * X[:, 2] + 10 + np.random.randn(100) * 2

# データ分割(訓練80% / テスト20%)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# モデル学習
model = LinearRegression()
model.fit(X_train, y_train)

# 予測値の計算
y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)

# 性能評価
train_r2 = r2_score(y_train, y_train_pred)
test_r2 = r2_score(y_test, y_test_pred)
test_rmse = np.sqrt(mean_squared_error(y_test, y_test_pred))

# 結果表示
print("[モデルの性能評価]")
print(f"訓練データのR²:\t{train_r2:.4f}")
print(f"テストデータのR²:\t{test_r2:.4f}  ← 汎化性能")
print(f"テストRMSE:\t{test_rmse:.4f}  ← 予測誤差")

# 過学習チェック
print("\n[過学習チェック]")
diff = abs(train_r2 - test_r2)
print(f"R²の差: {diff:.4f}")

if diff < 0.05:
    print("→ 過学習なし(良好)")
elif diff < 0.15:
    print("→ 若干の過学習あり")
else:
    print("→ 過学習が発生")
[モデルの性能評価]
訓練データのR²:    0.9814
テストデータのR²:  0.9427  ← 汎化性能
テストRMSE:       2.8407  ← 予測誤差

[過学習チェック]
R²の差: 0.0387
→ 過学習なし(良好)
6.6 実データでの実践
これまで学んだ技術を使って、実際のデータセットで回帰分析を実践してみましょう。ここでは Seaborn ライブラリに含まれる tips データセット(レストランのチップのデータ)を使用します。
6.6.1 Seaborn のデータセット
Seaborn は可視化ライブラリですが、学習用のサンプルデータセットも提供しています。主なデータセットには以下のようなものがあります:
- tips: レストランのチップに関するデータ
- iris: アヤメの花の分類データ
- penguins: ペンギンの種類と身体測定データ
- diamonds: ダイヤモンドの価格と特徴
その他のデータセット
Seabornには他にも以下のようなデータセットがあります:
- titanic: タイタニック号の乗客データ(生存予測)
- flights: 月別・年別の航空機の乗客数
- mpg: 自動車の燃費データ
- planets: 太陽系外惑星のデータ
- taxis: ニューヨークのタクシーの乗車データ
すべてのデータセット一覧は sns.get_dataset_names() 関数で確認できます。
今回は、チップの金額を予測する回帰問題として tips データセット を使います。
6.6.2 データセットの読み込みと確認
Seaborn のデータセットを読み込むためには、seaborn.load_dataset() 関数を使用します。
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score

# Seaborn から tips データセットを読み込み
tips = sns.load_dataset('tips')

# データの先頭を確認
print("データの先頭5行")
print(tips.head())

# データの形状
print(f"\nデータの形状: {tips.shape}")
print(f"({tips.shape[0]}件のデータ、{tips.shape[1]}個の列)")

# データの統計情報
print("\n数値データの統計情報")
print(tips.describe())

# データ型の確認
print("\nデータ型")
print(tips.dtypes)

# 欠損値の確認
print("\n欠損値の確認")
print(tips.isnull().sum())
データの先頭5行
   total_bill   tip     sex smoker  day    time  size
0       16.99  1.01  Female     No  Sun  Dinner     2
1       10.34  1.66    Male     No  Sun  Dinner     3
2       21.01  3.50    Male     No  Sun  Dinner     3
3       23.68  3.31    Male     No  Sun  Dinner     2
4       24.59  3.61  Female     No  Sun  Dinner     4

データの形状: (244, 7)
(244件のデータ、7個の列)

数値データの統計情報
       total_bill         tip        size
count  244.000000  244.000000  244.000000
mean    19.785943    2.998279    2.569672
std      8.902412    1.383638    0.951100
min      3.070000    1.000000    1.000000
25%     13.347500    2.000000    2.000000
50%     17.795000    2.900000    2.000000
75%     24.127500    3.562500    3.000000
max     50.810000   10.000000    6.000000

データ型
total_bill     float64
tip            float64
sex           category
smoker        category
day           category
time          category
size             int64
dtype: object

欠損値の確認
total_bill    0
tip           0
sex           0
smoker        0
day           0
time          0
size          0
dtype: int64
tips データセットの列
- total_bill: 食事代の合計金額(ドル)
- tip: チップの金額(ドル)← 予測対象
- sex: 性別(Male / Female)
- smoker: 喫煙者かどうか(Yes / No)
- day: 曜日(Thur / Fri / Sat / Sun)
- time: 時間帯(Lunch / Dinner)
- size: グループの人数
6.6.3 データの可視化
データの関係性を視覚的に確認してみましょう。
# 食事代とチップの関係を散布図で表示
plt.figure(figsize=(8, 6))
plt.scatter(tips['total_bill'], tips['tip'], alpha=0.6, s=50)
plt.xlabel('食事代(ドル)')
plt.ylabel('チップ(ドル)')
plt.title('食事代 vs チップ')
plt.grid(True, alpha=0.3)
plt.show()
データの傾向
散布図から、食事代が高いほどチップも高くなる傾向が見て取れます。このような関係性を数式で表現するのが回帰分析です。
演習問題では、このデータセットを使って実際に単回帰分析と重回帰分析を実装し、予測精度を評価していきます。
6.6.4 他のデータセットの紹介
Seaborn には他にもさまざまなデータセットがあります。ここでは、回帰分析の練習に使える 3 つのデータセットを紹介します。
iris データセット
iris(アヤメ)データセット は、アヤメの花の測定データです(150件)。
列の説明
- sepal_length: がく片の長さ(cm)
- sepal_width: がく片の幅(cm)
- petal_length: 花弁の長さ(cm)
- petal_width: 花弁の幅(cm)
- species: アヤメの種類(setosa / versicolor / virginica)
データの読み込み例
単回帰の例: 花弁の長さ(petal_length)から幅(petal_width)を予測
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score

X = iris[['petal_length']]
y = iris['petal_width']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

model = LinearRegression()
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
print(f"R² = {r2_score(y_test, y_pred):.4f}")
重回帰の例: がく片・花弁の長さから花弁の幅を予測
X = iris[['sepal_length', 'sepal_width', 'petal_length']]
y = iris['petal_width']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

model = LinearRegression()
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
print(f"R² = {r2_score(y_test, y_pred):.4f}")
penguins データセット
penguins(ペンギン)データセット は、南極のペンギン3種の測定データです(344件、欠損値あり)。
列の説明
- species: ペンギンの種類(Adelie / Chinstrap / Gentoo)
- island: 生息する島(Torgersen / Biscoe / Dream)
- bill_length_mm: くちばしの長さ(mm)
- bill_depth_mm: くちばしの深さ(mm)
- flipper_length_mm: ひれの長さ(mm)
- body_mass_g: 体重(g)
- sex: 性別(Male / Female)
データの読み込み例
diamonds データセット
diamonds(ダイヤモンド)データセット は、ダイヤモンドの特徴と価格のデータです(約54,000件)。
列の説明
- carat: カラット(重さ)
- cut: カットの品質(Fair / Good / Very Good / Premium / Ideal)
- color: 色(D / E / F / G / H / I / J)← Dが最高品質
- clarity: 透明度(I1 / SI2 / SI1 / VS2 / VS1 / VVS2 / VVS1 / IF)
- depth: 全体の深さの割合(%)
- table: テーブル面の幅の割合(%)
- price: 価格(ドル)
- x: 長さ(mm)
- y: 幅(mm)
- z: 深さ(mm)
データの読み込み例
import seaborn as sns
diamonds = sns.load_dataset('diamonds')
# データが大きいのでサンプリングして使用
diamonds_sample = diamonds.sample(5000, random_state=42)
print(diamonds_sample.head())
単回帰の例: カラット(carat)から価格(price)を予測
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score

diamonds_sample = diamonds.sample(5000, random_state=42)
X = diamonds_sample[['carat']]
y = diamonds_sample['price']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

model = LinearRegression()
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
print(f"R² = {r2_score(y_test, y_pred):.4f}")
重回帰の例: カラット・寸法から価格を予測
X = diamonds_sample[['carat', 'depth', 'table', 'x', 'y', 'z']]
y = diamonds_sample['price']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

model = LinearRegression()
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
print(f"R² = {r2_score(y_test, y_pred):.4f}")
データセットの選び方
- iris: 小規模でシンプル、初めての実践に最適
- penguins: 欠損値の処理を学べる、現実的なデータ
- diamonds: 大規模データ、サンプリングの実践
これらのデータセットを使って、自分でさまざまな特徴量の組み合わせを試してみましょう。演習問題でこれらのデータセットを使った回帰分析に挑戦します。
6.6.5 おまけ:カテゴリ変数の扱い方(ダミー変数化)
これまでは数値データのみを使った回帰分析を行ってきましたが、実際のデータには カテゴリ変数(文字列や分類データ)が含まれることがよくあります。tips データセットの例では、sex(性別)、smoker(喫煙者かどうか)、day(曜日)、time(時間帯)などがカテゴリ変数です。
カテゴリ変数とは
カテゴリ変数は、数値ではなく分類や名前で表現されるデータです。
- 性別: Male, Female
- 曜日: Mon, Tue, Wed, Thu, Fri, Sat, Sun
- 地域: 東京, 大阪, 福岡
機械学習モデル(線形回帰など)は数値データしか扱えないため、カテゴリ変数を数値に変換する必要があります。
ダミー変数化(One-Hot Encoding)
ダミー変数化 は、カテゴリ変数を 0 と 1 の列に変換する手法です。
例えば、sex が Male / Female の 2 値を取る場合:
| 元データ | sex_Male |
|---|---|
| Male | 1 |
| Female | 0 |
day が Thur / Fri / Sat / Sun の 4 値を取る場合(drop_first=True を使用):
| 元データ | day_Fri | day_Sat | day_Sun |
|---|---|---|---|
| Thur | 0 | 0 | 0 |
| Fri | 1 | 0 | 0 |
| Sat | 0 | 1 | 0 |
| Sun | 0 | 0 | 1 |
drop_first=True について
drop_first=True を指定すると、最初のカテゴリを削除します。これは 多重共線性 を避けるためです。
例えば、sex_Male と sex_Female の両方を含めると、一方が分かればもう一方も自動的に決まってしまい、モデルが不安定になります。
pandas でのダミー変数化
カテゴリ変数をダミー変数に変換するためには、pandas.get_dummies() 関数を使用します。
import pandas as pd
import seaborn as sns
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score

# tips データセットの読み込み
tips = sns.load_dataset('tips')

# カテゴリ変数をダミー変数化
tips_encoded = pd.get_dummies(tips, columns=['sex', 'smoker', 'day', 'time'],
                               drop_first=True)

print("ダミー変数化前")
print(tips.head())
print(f"列数: {tips.shape[1]}")

print("\nダミー変数化後")
print(tips_encoded.head())
print(f"列数: {tips_encoded.shape[1]}")

# 特徴量とターゲットを分離(tipを除くすべての列を特徴量として使用)
X = tips_encoded.drop('tip', axis=1)
y = tips_encoded['tip']

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# モデルの学習
model = LinearRegression()
model.fit(X_train, y_train)

# 係数の確認(上位5つ)
coef_df = pd.DataFrame({
    'Feature': X.columns,
    'Coefficient': model.coef_
}).sort_values('Coefficient', key=abs, ascending=False)

print("\n各特徴量の係数(上位5つ)")
print(coef_df.head())

# 性能評価
y_pred = model.predict(X_test)
r2 = r2_score(y_test, y_pred)
print(f"\n性能評価")
print(f"R²: {r2:.4f}")
ダミー変数化前
   total_bill   tip     sex smoker  day    time  size
0       16.99  1.01  Female     No  Sun  Dinner     2
1       10.34  1.66    Male     No  Sun  Dinner     3
2       21.01  3.50    Male     No  Sun  Dinner     3
3       23.68  3.31    Male     No  Sun  Dinner     2
4       24.59  3.61  Female     No  Sun  Dinner     4
列数: 7

ダミー変数化後
   total_bill   tip  size  sex_Female  ...  day_Fri  day_Sat  day_Sun  time_Dinner
0       16.99  1.01     2        True  ...    False    False     True         True
1       10.34  1.66     3       False  ...    False    False     True         True
2       21.01  3.50     3       False  ...    False    False     True         True
3       23.68  3.31     2       False  ...    False    False     True         True
4       24.59  3.61     4        True  ...    False    False     True         True

[5 rows x 9 columns]
列数: 9

各特徴量の係数(上位5つ)
       Feature  Coefficient
1         size     0.233484
3    smoker_No     0.192353
4      day_Fri     0.179721
6      day_Sun     0.128928
7  time_Dinner    -0.094957

性能評価
R²: 0.4373
ダミー変数化のポイント
いつ使うか
- カテゴリ変数(文字列や分類データ)を機械学習モデルで使いたい場合
使い方
注意点
drop_first=Trueを指定して多重共線性を回避- カテゴリが多い場合、列数が大幅に増加する
- 順序がある場合(例: 小・中・大)は、別の方法(順序エンコーディング)も検討
実データでの実践のまとめ
- Seabornのデータセット:
sns.load_dataset()関数でさまざまなデータセットを読み込める - データの確認:
head()メソッド,describe()メソッド,dtypes属性,isnull()メソッドでデータを把握 - データの可視化: 散布図でデータの傾向を視覚的に確認
- カテゴリ変数の処理:
pd.get_dummies()関数でダミー変数化 - データセットの選び方: 目的に応じて適切なデータセットを選択
6.7 演習問題
以下の演習では、6.6 で学んだ tips データセット を使って単回帰分析・重回帰分析・評価指標の計算を実装し、後半では人工データを使って多項式回帰と正則化を実験します。
演習 6-1: tips データセットで単回帰分析
演習 6-1
tips データセットを使って、食事代(total_bill)からチップ(tip)を予測する単回帰分析を実装してください。
タスク
- tips データセットを読み込み、先頭 5 行を表示する
- 特徴量
X = tips[['total_bill']]、ラベルy = tips['tip']を準備する - データを「訓練 80%、テスト 20%」(
random_state=42)に分割する - 線形回帰モデルを学習する
- 学習された 傾き(係数) と 切片 を表示する
- テストデータで予測し、RMSE と R² を計算して表示する
- 訓練データ(青)、テストデータ(緑)、回帰直線(赤)を 1 つの散布図で可視化する
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score

# 1. データの読み込みと先頭 5 行の表示

# 2. 特徴量 X とラベル y の設定

# 3. 訓練・テストに分割(8:2, random_state=42)

# 4. モデルの作成と学習

# 5. 傾きと切片の表示

# 6. テストデータで予測し、RMSE と R² を表示

# 7. 訓練データ・テストデータ・回帰直線を散布図で可視化
解答例
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score

# 1. データの読み込みと先頭 5 行の表示
tips = sns.load_dataset("tips")
print(tips.head())

# 2. 特徴量 X とラベル y の設定
X = tips[["total_bill"]]
y = tips["tip"]

# 3. 訓練・テストに分割(8:2, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 4. モデルの作成と学習
model = LinearRegression()
model.fit(X_train, y_train)

# 5. 傾きと切片の表示
print(f"傾き: {model.coef_[0]:.4f}")
print(f"切片: {model.intercept_:.4f}")

# 6. テストデータで予測し、RMSE と R² を表示
y_pred = model.predict(X_test)
rmse = np.sqrt(mean_squared_error(y_test, y_pred))
r2 = r2_score(y_test, y_pred)
print(f"RMSE: {rmse:.4f}")
print(f"R²:   {r2:.4f}")

# 7. 訓練データ・テストデータ・回帰直線を散布図で可視化
x_line = np.linspace(X["total_bill"].min(), X["total_bill"].max(), 100)
y_line = model.coef_[0] * x_line + model.intercept_

plt.figure(figsize=(8, 5))
plt.scatter(X_train, y_train, color="blue", alpha=0.5, label="訓練データ")
plt.scatter(X_test, y_test, color="green", alpha=0.7, label="テストデータ")
plt.plot(x_line, y_line, color="red", linewidth=2, label="回帰直線")
plt.xlabel("total_bill")
plt.ylabel("tip")
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
   total_bill   tip     sex smoker  day    time  size
0       16.99  1.01  Female     No  Sun  Dinner     2
1       10.34  1.66    Male     No  Sun  Dinner     3
2       21.01  3.50    Male     No  Sun  Dinner     3
3       23.68  3.31    Male     No  Sun  Dinner     2
4       24.59  3.61  Female     No  Sun  Dinner     4
傾き: 0.1070
切片: 0.9252
RMSE: 0.7542
R²:   0.5449
実行すると、青の訓練データと緑のテストデータの散布図に、右上がりの赤い回帰直線が重なったグラフが表示されます。
考察:傾き 0.1070 から、食事代が 1 ドル増えるとチップが約 0.11 ドル増えると読めます。R² は 0.5449 で、チップのばらつきの半分ほどしか食事代では説明できません。散布図でも、同じ食事代でチップが大きくばらついています。人数や曜日など、ほかの要因も影響していると考えられます。
演習 6-2: tips データセットで重回帰分析
演習 6-2
tips データセットを使って、食事代(total_bill)とグループサイズ(size)の 2 つの特徴量から、チップ(tip)を予測する重回帰分析を実装してください。
タスク
- 特徴量
X = tips[['total_bill', 'size']]、ラベルy = tips['tip']を準備する - データを「訓練 80%、テスト 20%」(
random_state=42)に分割する - 重回帰モデルを学習する
- 各特徴量の 係数 と 切片 を表示する
- テストデータで予測し、RMSE と R² を計算して表示する
- 横軸に実測値、縦軸に予測値をとった散布図を描き、
y = xの理想線(赤)も重ねて表示する
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score

tips = sns.load_dataset('tips')

# 1. 特徴量 X とラベル y の設定

# 2. 訓練・テストに分割(8:2, random_state=42)

# 3. モデルの作成と学習

# 4. 各特徴量の係数と切片の表示

# 5. テストデータで予測し、RMSE と R² を表示

# 6. 実測値 vs 予測値の散布図と理想線(y = x)
解答例
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score

tips = sns.load_dataset("tips")

# 1. 特徴量 X とラベル y の設定
X = tips[["total_bill", "size"]]
y = tips["tip"]

# 2. 訓練・テストに分割(8:2, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 3. モデルの作成と学習
model = LinearRegression()
model.fit(X_train, y_train)

# 4. 各特徴量の係数と切片の表示
for name, coef in zip(X.columns, model.coef_):
    print(f"{name} の係数: {coef:.4f}")
print(f"切片: {model.intercept_:.4f}")

# 5. テストデータで予測し、RMSE と R² を表示
y_pred = model.predict(X_test)
rmse = np.sqrt(mean_squared_error(y_test, y_pred))
r2 = r2_score(y_test, y_pred)
print(f"RMSE: {rmse:.4f}")
print(f"R²:   {r2:.4f}")

# 6. 実測値 vs 予測値の散布図と理想線(y = x)
plt.figure(figsize=(6, 6))
plt.scatter(y_test, y_pred, alpha=0.7)
lims = [y_test.min(), y_test.max()]
plt.plot(lims, lims, color="red", linewidth=2, label="y = x")
plt.xlabel("実測値(tip)")
plt.ylabel("予測値(tip)")
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
実行すると、実測値と予測値の散布図に赤い理想線(y = x)が重なったグラフが表示されます。点が理想線に近いほど予測が正確であることを意味します。
考察:食事代が 1 ドル増えるとチップが約 0.09 ドル、人数が 1 人増えると約 0.27 ドル増えると読めます。ただし total_bill は数十ドル、size は数人と値の範囲が違うので、係数の大きさだけでは影響の強さを比べられません。テストの R² は 0.4811 で、演習 6-1 の単回帰(0.5449)より下がりました。total_bill と size には相関があり、size を加えても新しい情報はあまり増えないためと考えられます。
演習 6-3: 4 つの評価指標と過学習チェック
演習 6-3
演習 6-2 と同じ重回帰モデル(total_bill, size → tip)について、訓練データとテストデータの両方で 4 つの評価指標(MSE, RMSE, MAE, R²)を計算し、過学習が起きていないか判定してください。
タスク
- データを「訓練 80%、テスト 20%」(
random_state=42)に分割する - 重回帰モデルを学習する
- 訓練データに対する予測値
y_train_predと、テストデータに対する予測値y_test_predを計算する - 訓練データの MSE, RMSE, MAE, R² を表示する
- テストデータの MSE, RMSE, MAE, R² を表示する
- 訓練 R² とテスト R² の差と、両方のスコアの水準を確認する。以下はこの演習内の仮の目安であり、普遍的な判定基準ではない
- 差 < 0.05 → 「過学習なし(良好)」
- 0.05 ≤ 差 < 0.15 → 「若干の過学習あり」
- 0.15 ≤ 差 → 「過学習が発生」
import numpy as np
import seaborn as sns
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score

tips = sns.load_dataset('tips')
X = tips[['total_bill', 'size']]
y = tips['tip']

# 1. 訓練・テストに分割(8:2, random_state=42)

# 2. モデルの作成と学習

# 3. 訓練データとテストデータそれぞれの予測値を計算

# 4. 訓練データの MSE, RMSE, MAE, R² を表示

# 5. テストデータの MSE, RMSE, MAE, R² を表示

# 6. 訓練 R² とテスト R² の差から過学習を判定
解答例
import numpy as np
import seaborn as sns
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score

tips = sns.load_dataset("tips")
X = tips[["total_bill", "size"]]
y = tips["tip"]

# 1. 訓練・テストに分割(8:2, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 2. モデルの作成と学習
model = LinearRegression()
model.fit(X_train, y_train)

# 3. 訓練データとテストデータそれぞれの予測値を計算
y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)

# 4. 訓練データの MSE, RMSE, MAE, R² を表示
mse_train = mean_squared_error(y_train, y_train_pred)
r2_train = r2_score(y_train, y_train_pred)
print("訓練データ")
print(f"  MSE:  {mse_train:.4f}")
print(f"  RMSE: {np.sqrt(mse_train):.4f}")
print(f"  MAE:  {mean_absolute_error(y_train, y_train_pred):.4f}")
print(f"  R²:   {r2_train:.4f}")

# 5. テストデータの MSE, RMSE, MAE, R² を表示
mse_test = mean_squared_error(y_test, y_test_pred)
r2_test = r2_score(y_test, y_test_pred)
print("テストデータ")
print(f"  MSE:  {mse_test:.4f}")
print(f"  RMSE: {np.sqrt(mse_test):.4f}")
print(f"  MAE:  {mean_absolute_error(y_test, y_test_pred):.4f}")
print(f"  R²:   {r2_test:.4f}")

# 6. 訓練 R² とテスト R² の差から過学習を判定
diff = r2_train - r2_test
print(f"訓練 R² とテスト R² の差: {diff:.4f}")
if diff < 0.05:
    print("判定: 過学習なし(良好)")
elif diff < 0.15:
    print("判定: 若干の過学習あり")
else:
    print("判定: 過学習が発生")
訓練データ
  MSE:  1.1141
  RMSE: 1.0555
  MAE:  0.7633
  R²:   0.4516
テストデータ
  MSE:  0.6486
  RMSE: 0.8054
  MAE:  0.6639
  R²:   0.4811
訓練 R² とテスト R² の差: -0.0295
判定: 過学習なし(良好)
考察:訓練 R²(0.4516)よりテスト R²(0.4811)のほうが高く、差は負になりました。この演習の基準では「過学習なし」です。ただし R² はどちらも 0.5 に届かず、予測がよく当たっているとはいえません。テストのほうが高いのは、テスト側に予測しやすいデータが入ったためで、random_state を変えると逆になることもあります。RMSE が MAE より大きいのは、RMSE が大きな誤差を重く数えるためです。
演習 6-4: 多項式回帰の次数比較と過学習の観察
演習 6-4
人工的に生成した非線形データに次数の異なる多項式回帰を当てはめて最適な次数を選び、次数を上げすぎると過学習が起きることを実験的に確認してください。
タスク
-
以下のコードで非線形データを生成する(コピペで OK)
-
データを「訓練 80%、テスト 20%」(
random_state=42)に分割する degrees = [1, 2, 3, 5, 10]の各次数について、多項式回帰モデルを学習する- 各次数について、
Pipelineクラスと5分割交差検証(KFold(n_splits=5, shuffle=True, random_state=42))を使い、訓練 R² と交差検証の平均 R² を表形式で表示する - 訓練データ内の交差検証の平均 R² が最大の次数を選び、選んだモデルだけを最終テストで評価する
- 挙動を観察するため、訓練データと各次数の予測曲線を 2×3 のサブプロットで可視化する
- 次数を上げたときの訓練 R² と交差検証 R² の差を見て、過学習の傾向を考察する
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
from sklearn.model_selection import train_test_split, KFold, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.metrics import r2_score
# 1. データ生成
np.random.seed(0)
X = np.sort(np.random.rand(80, 1) * 10, axis=0)
y = 0.3 * X.squeeze() ** 2 - 2 * X.squeeze() + 5 + np.random.randn(80) * 3
degrees = [1, 2, 3, 5, 10]
# 2. 訓練・テストに分割(8:2, random_state=42)
# 3. 各次数で多項式回帰モデルを学習
# 4. 訓練 R² と訓練データ内の5分割交差検証 R² を表示
# 5. 交差検証で次数を選び、選んだモデルだけを最終テストで評価
# 6. 各次数の予測曲線を 2×3 のサブプロットで可視化
解答例
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
from sklearn.pipeline import make_pipeline
from sklearn.model_selection import train_test_split, KFold, cross_val_score
from sklearn.metrics import r2_score

# 1. データ生成
np.random.seed(0)
X = np.sort(np.random.rand(80, 1) * 10, axis=0)
y = 0.3 * X.squeeze() ** 2 - 2 * X.squeeze() + 5 + np.random.randn(80) * 3
degrees = [1, 2, 3, 5, 10]

# 2. 最終テストを先に取り分ける
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)
cv = KFold(n_splits=5, shuffle=True, random_state=42)

# 3-4. 訓練データ内の同じ交差検証で次数を比較
results = []
fitted = {}
for degree in degrees:
    model = make_pipeline(PolynomialFeatures(degree=degree), LinearRegression())
    scores = cross_val_score(model, X_train, y_train, cv=cv, scoring="r2")
    model.fit(X_train, y_train)
    results.append({"次数": degree, "訓練R²": model.score(X_train, y_train),
                    "交差検証R²": scores.mean()})
    fitted[degree] = model
results_df = pd.DataFrame(results)
print(results_df.round(4).to_string(index=False))

# 5. 交差検証で次数を選び、選んだモデルだけを最終テストで評価
best = int(results_df.loc[results_df["交差検証R²"].idxmax(), "次数"])
print(f"交差検証で選んだ次数: {best}")
print(f"最終テストR²: {r2_score(y_test, fitted[best].predict(X_test)):.4f}")

# 6. 訓練データ上で各次数の曲線を観察(テスト結果で選び直さない)
x_line = np.linspace(0, 10, 300).reshape(-1, 1)
fig, axes = plt.subplots(2, 3, figsize=(15, 8))
for ax, degree in zip(axes.ravel(), degrees):
    ax.scatter(X_train, y_train, color="blue", alpha=0.5, label="訓練データ")
    ax.plot(x_line, fitted[degree].predict(x_line), color="red", label="予測曲線")
    ax.set_title(f"次数 {degree}")
    ax.grid(True, alpha=0.3)
    ax.legend()
axes.ravel()[-1].axis("off")
plt.tight_layout()
plt.show()
 次数   訓練R²  交差検証R²
  1 0.5389  0.4535
  2 0.6306  0.5393
  3 0.6306  0.5329
  5 0.6320  0.4457
 10 0.6532  0.3878
交差検証で選んだ次数: 2
最終テストR²: 0.3196
考察:訓練 R² は次数を上げるほど高くなりますが、交差検証 R² は次数 2(0.5393)が最も高く、次数 10 では 0.3878 まで下がります。選んだ次数 2 の最終テスト R² は 0.3196 でした。この結果を見て次数を選び直してはいけません。
演習 6-5: 正則化の効果を確認する
演習 6-5
演習 6-4 と同じ人工データに対して、次数 10 の多項式回帰にリッジ回帰とラッソ回帰を適用し、正則化の効果を確認してください。
タスク
- データを「訓練 80%、テスト 20%」(
random_state=42)に分割する - 次数 10 の
PolynomialFeaturesクラスで特徴量を変換する PolynomialFeaturesクラス・StandardScalerクラス・回帰モデルをPipelineクラスに入れ、LinearRegressionクラス、Ridge(alpha=0.1)、Lasso(alpha=0.1)を訓練データ内の同じ5分割交差検証で比較する- 交差検証の平均 RMSE が最小のモデルを選び、最終テストで RMSE と R² を一度だけ計算する
- 各モデルの係数の大きさ(絶対値の最大値)を比較し、正則化の効果を確認する
ヒント:次数 10 では x^10 のような高次の項の値が非常に大きくなるため、StandardScaler クラスで標準化してから学習すると結果が安定します。
import numpy as np
from sklearn.model_selection import train_test_split, KFold, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.linear_model import LinearRegression, Ridge, Lasso
from sklearn.metrics import mean_squared_error, r2_score

# データの生成(演習 6-4 と同じ)
np.random.seed(0)
X = np.sort(np.random.rand(80, 1) * 10, axis=0)
y = 0.3 * X.squeeze() ** 2 - 2 * X.squeeze() + 5 + np.random.randn(80) * 3

# 1. 訓練・テストに分割(8:2, random_state=42)

# 2. 次数 10 の PolynomialFeatures で特徴量を変換(標準化も行う)

# 3. LinearRegression, Ridge(alpha=0.1), Lasso(alpha=0.1) を学習

# 4. 交差検証の RMSE でモデルを選び、最終テストで RMSE と R² を計算

# 5. 各モデルの係数の絶対値の最大値を比較
解答例
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split, KFold, cross_val_score
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LinearRegression, Ridge, Lasso
from sklearn.metrics import mean_squared_error, r2_score

# データの作成(演習6-4と同じ)
np.random.seed(0)
X = np.sort(np.random.rand(80, 1) * 10, axis=0)
y = 0.3 * X.squeeze() ** 2 - 2 * X.squeeze() + 5 + np.random.randn(80) * 3

# 1. 最終テストを先に取り分ける
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)
cv = KFold(n_splits=5, shuffle=True, random_state=42)

# 2-3. 多項式変換・標準化を各foldの訓練部分だけで学習する
regressors = {
    "LinearRegression": LinearRegression(),
    "Ridge(alpha=0.1)": Ridge(alpha=0.1),
    "Lasso(alpha=0.1)": Lasso(alpha=0.1, max_iter=100000),
}
results = []
fitted = {}
for name, regressor in regressors.items():
    model = make_pipeline(PolynomialFeatures(degree=10, include_bias=False),
                          StandardScaler(), regressor)
    scores = cross_val_score(model, X_train, y_train, cv=cv,
                              scoring="neg_root_mean_squared_error")
    model.fit(X_train, y_train)
    results.append({"モデル": name, "交差検証RMSE": -scores.mean(),
                    "係数絶対値の最大": np.abs(model.steps[-1][1].coef_).max()})
    fitted[name] = model
results_df = pd.DataFrame(results)
print(results_df.round(4).to_string(index=False))

# 4. 交差検証RMSEで選んだモデルだけを最終テストで評価
best = results_df.loc[results_df["交差検証RMSE"].idxmin(), "モデル"]
y_pred = fitted[best].predict(X_test)
print(f"交差検証で選んだモデル: {best}")
print(f"最終テスト: RMSE {np.sqrt(mean_squared_error(y_test, y_pred)):.4f}, "
      f"R² {r2_score(y_test, y_pred):.4f}")

# 5. 訓練データで学習したLassoの係数を確認
lasso_coef = fitted["Lasso(alpha=0.1)"].steps[-1][1].coef_
print("Lasso の係数:", np.round(lasso_coef, 3))
print(f"0 になった係数の数: {np.sum(lasso_coef == 0)} / {len(lasso_coef)}")
             モデル  交差検証RMSE    係数絶対値の最大
LinearRegression    3.4295 567708.2366
Ridge(alpha=0.1)    3.0035      1.6903
Lasso(alpha=0.1)    2.8860      2.4528
交差検証で選んだモデル: Lasso(alpha=0.1)
最終テスト: RMSE 2.6535, R² 0.3496
Lasso の係数: [0.    1.064 2.453 0.    0.    0.    0.    0.    0.    0.   ]
0 になった係数の数: 8 / 10
考察:係数絶対値の最大は、LinearRegression クラスの約57万に対して、Ridge クラスで1.69、Lasso クラスで2.45に抑えられました。Lasso クラスでは10個中8個の係数が0です。モデルは交差検証 RMSE が最小の Lasso クラスを選び、最終テストは一度だけ評価しています。残った項が生成式の項と一致するとは限りません。alpha も探すときは、同じパイプラインを GridSearchCV クラスに渡して訓練データ内で選びます。
まとめ
本章では、機械学習における基本的なモデルについて学びました。
第 6 章のまとめ
単回帰分析
- 1つの特徴量から予測を行う最もシンプルな手法
- NumPy配列とpandas DataFrameの両方で実装できる
- 実務ではpandasを使うことが多い
重回帰分析
- 複数の特徴量を使ってより精度の高い予測を実現
- 係数を見ることで、各特徴量の影響度を理解できる
多項式回帰
- 非線形な関係を表現できる
- 次数を上げすぎると過学習のリスク
- 適切な次数は交差検証で決定
モデルの性能評価
- MSE: 誤差の二乗の平均
- RMSE: MSEの平方根(最も一般的)
- MAE: 誤差の絶対値の平均
- R²: 評価データの分散に対する当てはまり(1に近いほど良く、負になる場合もある)
- 訓練データとテストデータの両方で評価し、過学習を検出
(以下は発展)
正則化(Ridge・Lasso)
- Ridge回帰: すべての特徴量を使用、係数を小さく抑える
- Lasso回帰: 不要な特徴量の係数を0にする(特徴量選択)
- 過学習を防ぐための重要な手法
次章以降は、分類問題や、より高度な機械学習手法を学んでいきます。