7. 分類

本章では、機械学習における基本的な分類(Classification) モデルとして、ロジスティック回帰、ナイーブベイズ、k-近傍法、サポートベクターマシン(SVM) を学びます。あわせて、分類モデルを評価するための指標(正解率、混同行列、適合率、再現率、F1 スコア)についても扱います。
まず、分類問題の基礎を確認しておきましょう。分類問題は大きく以下の 2 つに分けることができます。
graph TB
    A("分類問題") --> B("2値分類<br/>Binary Classification")
    A --> C("多値分類<br/>Multi-class Classification")

    B --> B1("2つのクラスに分類<br/>例: スパム判定 Yes/No<br/>病気の有無 有/無")
    C --> C1("3つ以上のクラスに分類<br/>例: アヤメの種類 3種<br/>手書き数字 0-9")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef neu fill:#F2F2F2,stroke:#8C8C8C,stroke-width:2px,color:#000
    class A neu
    class B,B1 data
    class C,C1 proc
2 値分類(Binary Classification):
- 正解ラベルが 2 つ(Yes/No、True/False、0/1 など)
- 例:メールがスパムかどうか、病気の有無
多値分類(Multi-class Classification):
- 正解ラベルが 3 つ以上
- 例:アヤメの種類(3 種)、手書き数字(0-9 の 10 種類)
7.1 ロジスティック回帰
7.1.1 ロジスティック回帰とは
ロジスティック回帰(Logistic Regression) は、名前に「回帰」とついていますが、分類 のためのアルゴリズムです。
線形回帰では \(y = ax + b\) という式で数値を予測しましたが、ロジスティック回帰では シグモイド関数 を使って、0 から 1 の間の確率を出力します。
graph LR
    A("入力<br/>x") --> B("線形結合<br/>z = w·x + b")
    B --> C("シグモイド関数<br/>σz = 1/1+e⁻ᶻ")
    C --> D("確率<br/>0 ≤ P ≤ 1")
    D --> E("分類<br/>P ≥ 0.5 → クラス1<br/>P < 0.5 → クラス0")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    class A data
    class B,C proc
    class D,E out
シグモイド関数
シグモイド関数は、任意の実数を 0 から 1 の間の値に変換する関数です。
- 入力が大きい正の数 → 1 に近づく
- 入力が大きい負の数 → 0 に近づく
- 入力が 0 → ちょうど 0.5
この性質により、確率を表現するのに適しています。
7.1.2 ロジスティック回帰の実装
scikit-learn でロジスティック回帰を実装するには、sklearn.linear_model.LogisticRegression クラスを使用します。
import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
import seaborn as sns

# tipsデータセットの読み込み
tips = sns.load_dataset('tips')

# データの確認
print(tips.head())

# 特徴量とラベルの分離(チップから時間帯を予測)
X = tips[['tip']]
y = tips['time'].values # Dinne or Lunch

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# ロジスティック回帰モデルの学習
model = LogisticRegression()
model.fit(X_train, y_train)

# 予測
y_pred = model.predict(X_test)

# 精度の計算
accuracy = accuracy_score(y_test, y_pred)
print(f"\n精度: {accuracy:.2%}")
   total_bill   tip     sex smoker  day    time  size
0       16.99  1.01  Female     No  Sun  Dinner     2
1       10.34  1.66    Male     No  Sun  Dinner     3
2       21.01  3.50    Male     No  Sun  Dinner     3
3       23.68  3.31    Male     No  Sun  Dinner     2
4       24.59  3.61  Female     No  Sun  Dinner     4

精度: 69.39%
この予測結果の詳しい評価(混同行列や適合率・再現率など)は、7.5 節で扱います。
7.1.3 多値分類への拡張
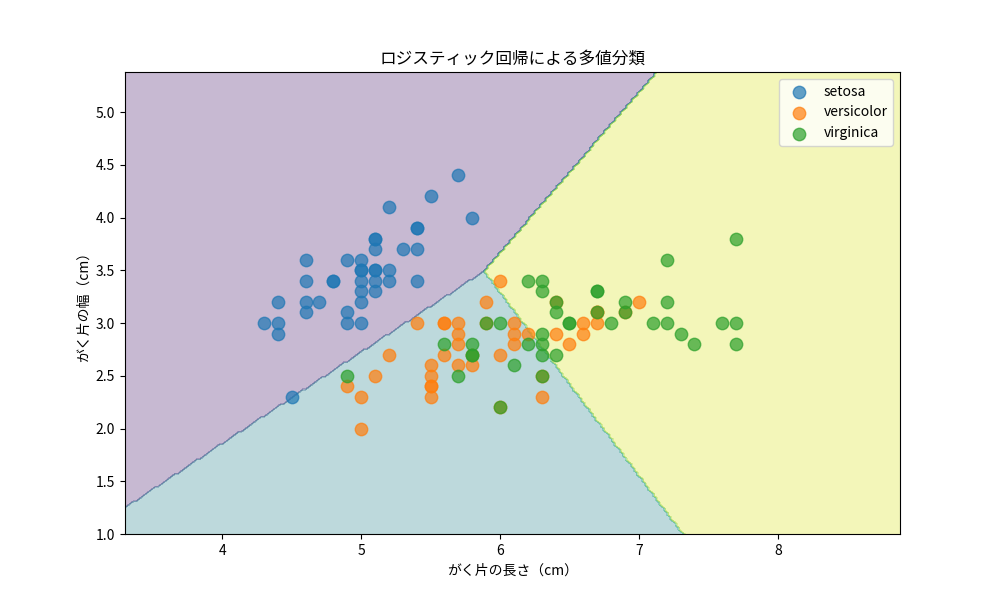
ロジスティック回帰は、多値分類にも対応できます。scikit-learn の LogisticRegression クラスはデフォルトで多値分類をサポートしています。クラスごとの精度・適合率・再現率・F1 スコアをまとめて確認するには sklearn.metrics.classification_report() 関数が便利です。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, classification_report
import seaborn as sns

# アヤメデータセットの読み込み
iris = sns.load_dataset('iris')

# 特徴量とラベルの分離
X = iris[['sepal_length', 'sepal_width']].values
y = iris['species'].values

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# モデルの学習
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)

# 予測
y_pred = model.predict(X_test)

# 精度の計算
accuracy = accuracy_score(y_test, y_pred)
print(f"精度: {accuracy:.2%}")

# 詳細なレポート
print("\n分類レポート:")
print(classification_report(y_test, y_pred))
精度: 90.00%

分類レポート:
              precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        10
  versicolor       0.88      0.78      0.82         9
   virginica       0.83      0.91      0.87        11

    accuracy                           0.90        30
   macro avg       0.90      0.90      0.90        30
weighted avg       0.90      0.90      0.90        30
分類結果の可視化例
Playground:ロジスティック回帰
ロジスティック回帰 の Playground では、重み \(w_1\)・\(w_2\) と切片 \(b\) を動かして 2 クラスを分ける決定境界を手で探せます。背景の濃さがシグモイドで変換された確率を表し、境界は確率がちょうど 0.5 になる線です。グラフをクリックして点を追加すると最適な境界が変わることも試せます。
7.2 ナイーブベイズ
7.2.1 ナイーブベイズとは
ナイーブベイズ(Naive Bayes) は、ベイズの定理を使った確率的な分類手法です。「ナイーブ(単純)」という名前は、同じクラスの中では各特徴量が互いに独立であるという仮定から来ています。実際のデータでは特徴量間に依存関係があることも多いですが、この仮定の下でも実用的に動作します。
ナイーブベイズの特徴
- 学習が高速(パラメータをカウントするだけ)
- 少ないデータでも安定する
- テキスト分類(スパムフィルタなど)と相性が良い
- 特徴量の独立性を仮定するため、相関の強い特徴量があると不利
7.2.2 ベイズの定理と直感的な理解
ナイーブベイズの土台となる ベイズの定理 は、次の式で表されます。
ここで、\(P(C \mid X)\) はデータ \(X\) が与えられたときにクラス \(C\) である確率(事後確率)、\(P(X \mid C)\) はクラス \(C\) のデータが特徴 \(X\) を持つ確率(尤度)、\(P(C)\) はクラス \(C\) がどれくらいの割合で出現するかの確率(事前確率)、\(P(X)\) は特徴 \(X\) が観測される確率です。
ベイズの定理を直感的に理解するために、スパムメールの判定を例にとって考えてみましょう。
過去のメールデータから、次のことがわかっているとします。
- 全メールのうち、スパムの割合は 20%(\(P(\text{スパム}) = 0.2\))
- スパムメールに「当選」という単語が含まれる確率は 60%(\(P(\text{「当選」} \mid \text{スパム}) = 0.6\))
- 通常メールに「当選」という単語が含まれる確率は 1%(\(P(\text{「当選」} \mid \text{通常}) = 0.01\))
- メールが通常メールかスパムメールかにかかわらず、「当選」という単語が含まれる確率は 12.8%(\(P(\text{「当選」}) = P(\text{「当選」} \mid \text{スパム}) \cdot P(\text{スパム}) + P(\text{「当選」} \mid \text{通常}) \cdot P(\text{通常}) = 0.6 \times 0.2 + 0.01 \times 0.8 = 0.128\))
「当選」という単語を含むメールがスパムである確率は、ベイズの定理を使って次のように計算できます。
つまり、「当選」という単語を含むメールはスパムである確率が約 94% と計算されます。ナイーブベイズは、このような計算を複数の特徴量に対して行い、最も確率が高いクラスに分類します。
7.2.3 GaussianNB による分類
scikit-learn では、特徴量が連続値の場合に sklearn.naive_bayes.GaussianNB クラスを使います。これは、クラスごとに各特徴量が正規分布に従うと仮定するモデルです。
from sklearn.naive_bayes import GaussianNB
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
import seaborn as sns

# アヤメデータセットの読み込み
iris = sns.load_dataset('iris')

# 特徴量とラベル
X = iris[['sepal_length', 'sepal_width',
          'petal_length', 'petal_width']].values
y = iris['species'].values

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# ナイーブベイズモデルの学習
model = GaussianNB()
model.fit(X_train, y_train)

# 予測と精度
y_pred = model.predict(X_test)
print(f"正解率: {accuracy_score(y_test, y_pred):.2%}")

# 予測確率の確認(最初の3件)
y_proba = model.predict_proba(X_test)[:3]
print(f"\n予測確率(最初の3件):")
print(f"{'setosa':>10s} {'versicolor':>12s} {'virginica':>10s}")
for i in range(3):
    print(f"{y_proba[i, 0]:10.4f} {y_proba[i, 1]:12.4f}"
          f" {y_proba[i, 2]:10.4f}")
正解率: 100.00%

予測確率(最初の3件):
    setosa   versicolor  virginica
    0.0000       0.9956     0.0044
    1.0000       0.0000     0.0000
    0.0000       0.0000     1.0000
7.2.4 ナイーブベイズの種類
scikit-learn には、データの性質に応じた複数のナイーブベイズが用意されています。
| クラス名 | 想定するデータ | 主な用途 |
|---|---|---|
GaussianNB |
連続値(正規分布) | 数値データの分類 |
MultinomialNB |
離散値(カウント) | テキスト分類(単語の出現回数) |
BernoulliNB |
二値(0/1) | テキスト分類(単語の有無) |
テキスト分類(スパムフィルタ、ニュース記事の分類など)では、多項ナイーブベイズ(Multinomial Naive Bayes) が特に広く使われています。文書を単語の出現回数で表現し、各カテゴリにおける単語の出現確率からクラスを判定します。
graph LR
    A("文書") --> B("単語頻度")
    B --> C("クラスごとの<br/>単語出現確率")
    C --> D("ベイズの定理")
    D --> E("クラス確率<br/>を計算")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    class A,B data
    class D proc
    class C model
    class E out
この場合の計算もシンプルです。「クラス \(C\) のときに単語 \(w\) が現れる確率 \(P(w|C)\)」をデータから数え、文書中の全単語についてその確率の積をとります。
たとえばスパム判定なら、「無料」「割引」「当選」などの単語がスパムに頻出することがデータから分かれば、それらを含むメールは自動的にスパム確率が高く判定されます。
ナイーブベイズが使われる場面
- スパムフィルタ:定番の用途。少ないルールで高速に判定できる
- トピック分類:ニュース記事のカテゴリ分けなど
- 高速なベースライン:本格的なモデルを試す前の比較対象として優秀
Playground:ナイーブベイズ
ナイーブベイズ分類 の Playground では、クラスを選んでグラフをクリックすると、ガウシアン・ナイーブベイズが各クラスの平均と分散を学習し直し、決定境界がその場で引き直されます。片方のクラスにばかり点を足すと事前確率が変わって境界が動くことも確かめてみましょう。
7.3 k-近傍法
7.3.1 k-近傍法とは
k-近傍法(k-Nearest Neighbors, k-NN) は、新しいデータを分類するときに「最も近い k 個の訓練データ」を見て、その多数決でクラスを決める非常にシンプルなアルゴリズムです。
graph LR
    A("新しいデータ") --> B("訓練データとの<br/>距離を計算")
    B --> C("近い順に k 個選ぶ")
    C --> D("多数決でクラス決定")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    class A data
    class B,C proc
    class D out
k-NN の特徴
- 学習がない(怠惰学習):訓練データをそのまま記憶するだけで、予測時に距離計算する
- 非線形な境界:複雑な決定境界を表現できる
- 解釈しやすい:「近いデータと同じクラス」という直感的なルール
- 距離に敏感:特徴量のスケールの影響を強く受けるため、通常は標準化する
- 予測が遅い:データ数が多いほど予測時の計算量が増える
ロジスティック回帰との違い
| ロジスティック回帰 | k-近傍法 | |
|---|---|---|
| 学習方法 | パラメータを最適化 | 訓練データを記憶するだけ |
| 決定境界 | 線形 | 非線形(局所的) |
| 予測速度 | 速い | 遅い(データ数に比例) |
| データのスケール | 影響少なめ | 通常は標準化 |
7.3.2 k-近傍法の実装
scikit-learn で k-NN を実装するには、sklearn.neighbors.KNeighborsClassifier クラスを使用します。距離ベースの手法なので、特徴量の標準化 をセットで行うのが基本です(標準化には sklearn.preprocessing.StandardScaler クラスを使います)。
import numpy as np
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, classification_report
import seaborn as sns

# アヤメデータセットの読み込み
iris = sns.load_dataset('iris')
X = iris[['sepal_length', 'sepal_width', 'petal_length', 'petal_width']].values
y = iris['species'].values

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 標準化(訓練データで fit、テストには transform のみ)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# k-NN モデルの学習(k=5)
model = KNeighborsClassifier(n_neighbors=5)
model.fit(X_train_scaled, y_train)

# 予測と評価
y_pred = model.predict(X_test_scaled)
print(f"精度: {accuracy_score(y_test, y_pred):.2%}")
print("\n分類レポート:")
print(classification_report(y_test, y_pred))
精度: 100.00%

分類レポート:
              precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        10
  versicolor       1.00      1.00      1.00         9
   virginica       1.00      1.00      1.00        11

    accuracy                           1.00        30
   macro avg       1.00      1.00      1.00        30
weighted avg       1.00      1.00      1.00        30
標準化を忘れるとどうなるか
例えば「年齢(0〜100)」と「年収(0〜10,000,000)」を特徴量に使うと、年収のスケールが大きすぎて距離計算がほぼ年収だけで決まってしまいます。
StandardScaler クラスで各特徴量を「平均0・標準偏差1」に揃えることで、全ての特徴量が公平に距離に寄与するようになります。
7.3.3 ハイパーパラメータ k の選び方
k-NN の最も重要なハイパーパラメータが n_neighbors(= k) です。
- k が小さい(例:k = 1):1 つの近傍だけで決めるため、ノイズに敏感で 過学習しやすい
- k が大きい:広い範囲を見るため境界が滑らかになるが、大きすぎると 未学習 になる
import matplotlib.pyplot as plt
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
import seaborn as sns

iris = sns.load_dataset('iris')
X = iris[['sepal_length', 'sepal_width', 'petal_length', 'petal_width']].values
y = iris['species'].values

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# k を変えて精度を比較
ks = range(1, 21)
train_acc, test_acc = [], []
for k in ks:
    model = KNeighborsClassifier(n_neighbors=k)
    model.fit(X_train_scaled, y_train)
    train_acc.append(model.score(X_train_scaled, y_train))
    test_acc.append(model.score(X_test_scaled, y_test))

plt.figure(figsize=(8, 5))
plt.plot(ks, train_acc, marker='o', label='訓練精度')
plt.plot(ks, test_acc, marker='s', label='テスト精度')
plt.xlabel('k (n_neighbors)')
plt.ylabel('精度')
plt.title('k-NN: k と精度の関係')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
適切な k の選び方
- 目安:\(k = \sqrt{\rm (訓練データ数)}\) 付近から試す
- 奇数を選ぶ:2 値分類の場合、多数決で同票になるのを避けるため
- 交差検証:
GridSearchCVクラスなどで複数の k を試して最も良いものを選ぶ
Playground:k近傍法(k-NN)
k近傍法(k-NN) の Playground では、k のスライダーを動かすと決定領域の形が変わります。k が小さいうちは境界がギザギザでノイズに振り回され(過学習気味)、k を大きくするとなめらかになります。この節で学んだ k の選び方を目で確かめられます。グラフをクリックすると、その点から近傍 k 個への線と多数決の結果が表示されます。
7.4 サポートベクターマシン
7.4.1 SVM とは
サポートベクターマシン(Support Vector Machine, SVM) は、クラスを分ける「境界」をマージン(margin)が最大になるように引く分類アルゴリズムです。ロジスティック回帰や k-近傍法と同じく「特徴量空間で境界を引く」手法ですが、SVM は「境界からデータ点までの距離(マージン)を最大化する」ことで、汎化性能の高い境界を得ることができます。
SVM の特徴
- マージン最大化:境界とデータ点の距離(マージン)が最も大きくなる境界を選ぶため、汎化性能が高い
- カーネルトリック:非線形な境界も扱える(後述)
- 少データに強い:サンプルが少ない場面でも安定して動きやすい
- 標準化を通常行う:内積やカーネルの計算が特徴量のスケールの影響を受ける
- 大規模データに弱い:学習計算量がサンプル数に対して大きい(〜サンプル数の2〜3乗)
7.4.2 線形 SVM の考え方
マージン最大化
SVM のキモは「境界線の引き方」です。2 クラスを分ける直線は無数に引けますが、SVM は「両クラスから最も遠い(=マージンが最大の)境界」を選びます。
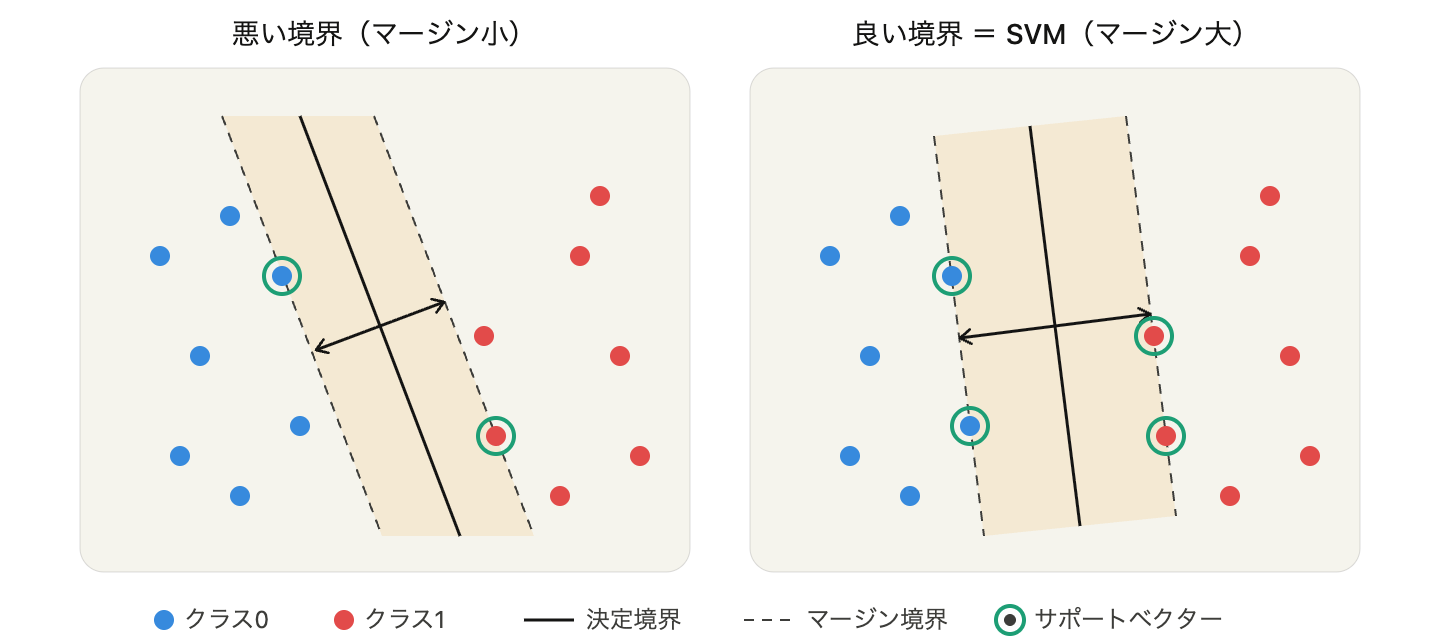
上図のように、同じデータでも引ける境界は無数にあります。SVM は境界から最も近いデータ点(サポートベクター、緑の丸)までの距離=マージンが最大になる境界を選びます。マージンが大きいほど、未知のデータに対しても正しく分類できる可能性が高くなります。
数式による定式化
2 クラス分類(ラベル \(y_i \in \{-1, +1\}\))で、決定境界を \(\mathbf{w} \cdot \mathbf{x} + b = 0\) とします。
線形 SVM の最適化問題
SVM は以下の最適化問題を解きます。
- \(\mathbf{w}\):境界面の法線ベクトル(境界の向きを決める)
- \(b\):バイアス項(境界の位置を決める)
- \(\|\mathbf{w}\|^2\) を最小化 = マージン \(\frac{2}{\|\mathbf{w}\|}\) を最大化
- 制約条件:全てのデータ点が正しく分類され、境界からの距離が 1 以上
直感的には「全データ点を正しく分類しつつ、マージンが最大になる \(\mathbf{w}\) と \(b\) を見つけよ」という問題です。
ソフトマージン SVM
現実のデータは完全に線形分離できないことが多いため、多少の誤分類を許容する ソフトマージン SVM を使います。
ソフトマージン SVM の最適化問題
各データ点に「マージン違反の度合い」\(\xi_i \geq 0\)(スラック変数)を導入します。
この目的関数は 2 つの項のバランスを取っています。
- \(\frac{1}{2} \|\mathbf{w}\|^2\):正則化項(マージンを広くする=モデルをシンプルに)
- \(C \sum \xi_i\):損失項(誤分類・マージン違反を減らす=データに合わせる)
\(C\) は両者のバランスを制御するパラメータです。
- \(C\) が大きい:損失項を重視 → 誤分類を許さない → マージンが狭く、過学習しやすい
- \(C\) が小さい:正則化項を重視 → 誤分類を許容 → マージンが広く、汎化しやすい
ロジスティック回帰の C と同じく、\(C\) が大きいほど正則化が弱い(=データに忠実、複雑な境界)という点に注意してください。
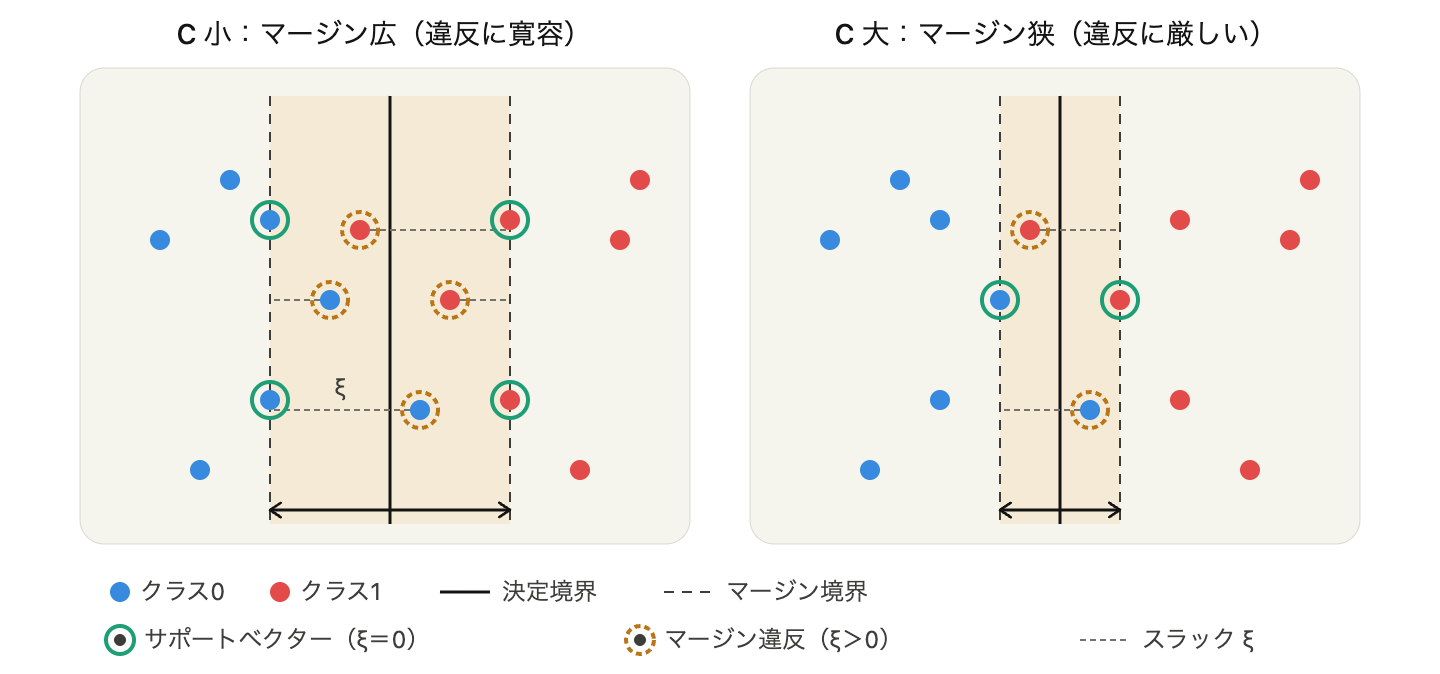
上図のように、\(C\) の大きさでマージンの広さと違反の許容度が変わります。
- \(C\) 小(左):マージンが広く、マージン内に入り込む点(\(\xi > 0\)、オレンジ破線の丸)を多く許容する。境界はシンプルだが、誤分類もやや増える
- \(C\) 大(右):マージンが狭く、違反を厳しく罰する。サポートベクター(緑の丸、\(\xi = 0\))のみがマージン境界上に並ぶ
7.4.3 RBF カーネルと非線形 SVM
なぜカーネルが必要か
直線では分けられないデータも存在します(下図の同心円データなど)。こうしたデータを分類するには、データを高次元空間に写像して、そこで線形に分離するというアイデアが考えられます。
graph LR
    A("元の空間(2次元)<br/>線形分離不可能") -->|"写像 φ"| B("高次元空間<br/>線形分離可能")
    B --> C("高次元で<br/>線形 SVM")
    C --> D("元の空間では<br/>非線形な境界")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    class A,B data
    class C model
    class D out
しかし、高次元空間での計算は非常にコストがかかります。ここで登場するのが カーネルトリック です。
カーネルトリック
線形 SVM の最適化問題は、実はデータ点同士の内積 \(\mathbf{x}_i \cdot \mathbf{x}_j\) だけで解けることが知られています。カーネルトリックとは、高次元空間での内積 \(\phi(\mathbf{x}_i) \cdot \phi(\mathbf{x}_j)\) を、元の空間で計算できるカーネル関数 \(K(\mathbf{x}_i, \mathbf{x}_j)\) で置き換えるテクニックです。
- \(\phi\):高次元空間への写像(実際には計算しない)
- \(K\):カーネル関数(元の空間の座標だけで計算できる)
つまり、データを実際に高次元に変換することなく、高次元で線形 SVM を解いたのと同じ結果が得られます。RBF カーネルの場合、写像先は無限次元ですが、カーネル関数の値は元の空間の距離だけで簡単に計算できます。
RBF カーネルの数式
最もよく使われる RBF(Radial Basis Function)カーネル は、2 つのデータ点 \(\mathbf{x}_i\) と \(\mathbf{x}_j\) の「類似度」を次のように定義します。
RBF カーネル関数
- \(\|\mathbf{x}_i - \mathbf{x}_j\|^2\):2 点間のユークリッド距離の 2 乗
- \(\gamma > 0\):カーネルの「幅」を制御するパラメータ
直感的な理解:
- 2 点が 近い → \(K\) が 1 に近い(類似している)
- 2 点が 遠い → \(K\) が 0 に近い(類似していない)
- \(\gamma\) が 大きい → 近い点だけに反応 → 境界が複雑(過学習しやすい)
- \(\gamma\) が 小さい → 遠い点にも反応 → 境界が滑らか(汎化しやすい)
scikit-learn のデフォルト gamma='scale' は \(\gamma = \frac{1}{n_\text{features} \cdot \text{Var}(X)}\) と自動設定されます。
カーネル関数の比較
| カーネル | 数式 | 境界の形 | 用途 |
|---|---|---|---|
linear |
\(K(\mathbf{x}_i, \mathbf{x}_j) = \mathbf{x}_i \cdot \mathbf{x}_j\) | 直線・超平面 | 特徴量数が多い・線形分離可能 |
rbf |
\(K(\mathbf{x}_i, \mathbf{x}_j) = \exp(- \gamma \|\mathbf{x}_i - \mathbf{x}_j\|^2)\) | 円・楕円・複雑な形状 | 一般的・最初に試す |
poly |
\(K(\mathbf{x}_i, \mathbf{x}_j) = (\gamma \, \mathbf{x}_i \cdot \mathbf{x}_j + r)^d\) | 多項式曲線 | 滑らかな非線形 |
RBF カーネルの決定境界
線形分離できない同心円状のデータに対して RBF カーネル SVM を適用することで、非線形な決定境界を得ることができます。
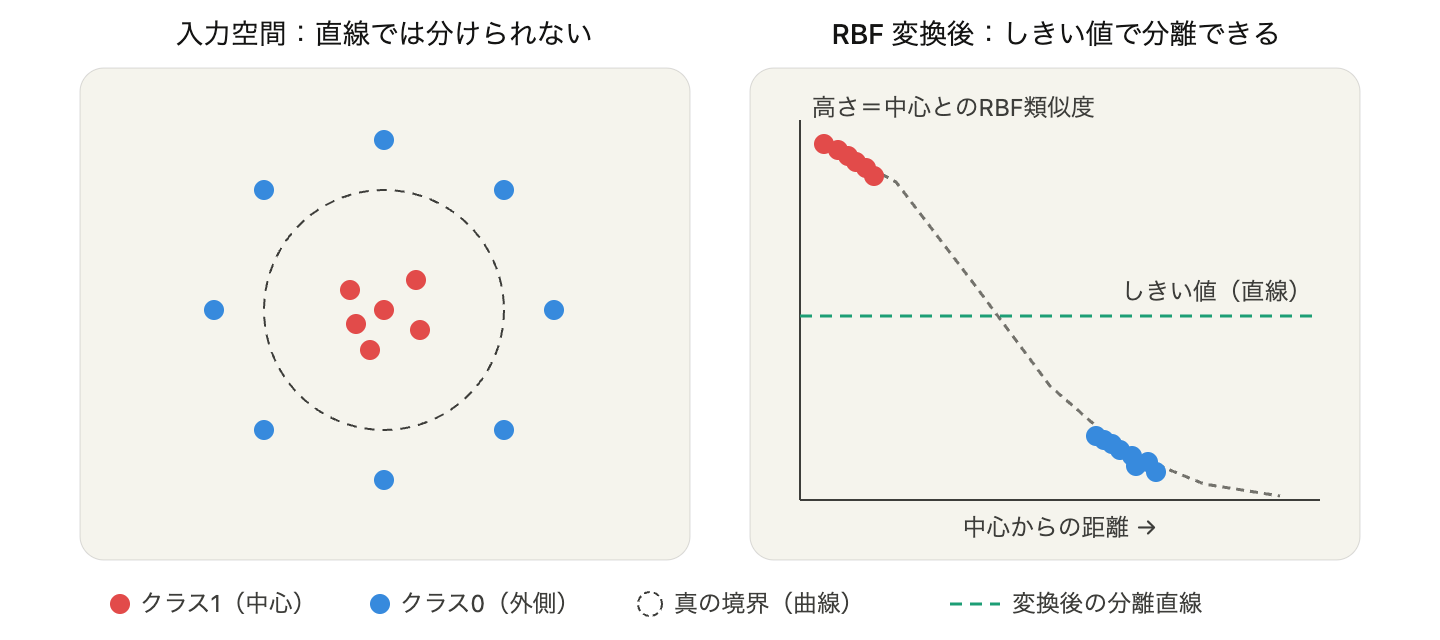
上図のように、線形カーネルでは分離できないデータも、RBF カーネルなら非線形な境界で(高次元空間では線形な境界で)正しく分類できます。
gamma の影響の可視化
RBF カーネルでは gamma の値が決定境界の複雑さを大きく左右します。
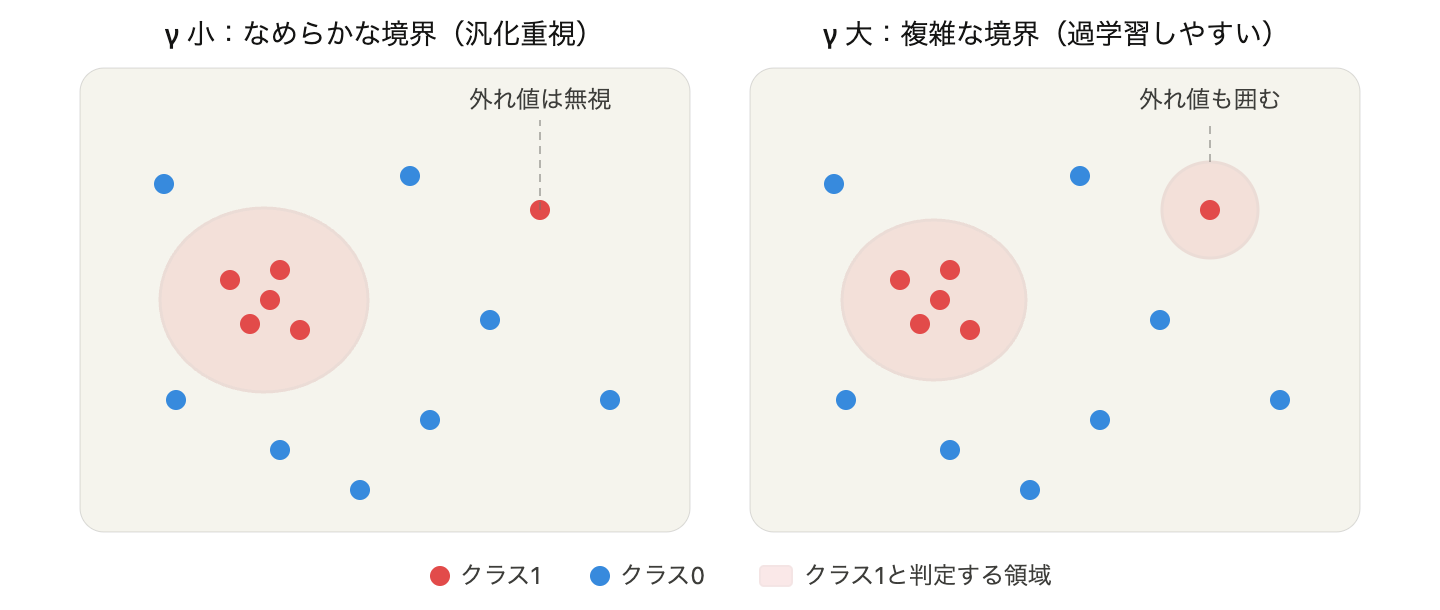
| gamma | 境界の特徴 | リスク |
|---|---|---|
| 小(0.1) | 滑らかで広い境界 | 未学習(境界が単純すぎる) |
| 中(1.0) | 適度な複雑さ | バランスが良い |
| 大(10.0) | 各データ点に密着した複雑な境界 | 過学習(訓練データに過度に適合) |
7.4.4 SVM の実装
SVM を実装するには、sklearn.svm.SVC クラスを使用します。SVM は距離ベースの手法なので、sklearn.preprocessing.StandardScaler クラスによる標準化をセットで行うのが基本です。
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
import seaborn as sns

# アヤメデータセットの読み込み
iris = sns.load_dataset('iris')
X = iris[['petal_length', 'petal_width']].values
y = iris['species'].values

# データ分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 標準化(SVM では通常行う)
scaler = StandardScaler()
X_train_s = scaler.fit_transform(X_train)
X_test_s = scaler.transform(X_test)

# SVM モデルの学習(RBF カーネル)
model = SVC(kernel='rbf', C=1.0, gamma='scale', random_state=42)
model.fit(X_train_s, y_train)

# 予測と評価
y_pred = model.predict(X_test_s)
accuracy = accuracy_score(y_test, y_pred)
print(f"精度: {accuracy:.2%}")
7.4.5 SVM のハイパーパラメータ
| パラメータ | 説明 | 影響 |
|---|---|---|
kernel |
カーネルの種類 | 'rbf'(デフォルト)/ 'linear' / 'poly' |
C |
マージン違反のペナルティ | 小さい→シンプル、大きい→複雑 |
gamma |
RBF カーネルの幅 | 'scale'(自動)が無難 |
C と gamma の組み合わせ
C と gamma はどちらも境界の複雑さに影響するため、両方を同時に調整する必要があります。一般的には GridSearchCV クラスや RandomizedSearchCV クラスで組み合わせを探索します。
| gamma 小 | gamma 大 | |
|---|---|---|
| C 小 | 非常にシンプルな境界 | やや複雑だが正則化あり |
| C 大 | 滑らかだが厳密に分類 | 非常に複雑(過学習リスク大) |
SVM を使うべきケース
- 中規模データ(〜数万件)の分類
- 特徴量数 ≧ サンプル数(テキスト分類など)
- 非線形な決定境界が必要で、他の手法が過学習する場合
一方、サンプル数が数十万件を超える場合は、SVM の学習が遅くなるため、ランダムフォレストや LightGBM の方が現実的です。
Playground:サポートベクターマシン
サポートベクターマシン の Playground では、正則化パラメータ \(C\) を動かすとマージン(すき間の帯)の広さが変わります。\(C\) を小さくすると帯が広がって多少の誤分類を許し、大きくすると帯が狭まって誤分類を強く避けます。その結果サポートベクターの数がどう変わるかを観察してみましょう。
7.5 分類モデルの評価指標
分類問題では、回帰問題とは異なる評価指標を使います。
graph LR
    A("分類モデルの評価指標") --> B("正解率<br/>Accuracy")
    A --> C("適合率<br/>Precision")
    A --> D("再現率<br/>Recall")
    A --> E("F1スコア<br/>F1-Score")
    A --> F("混同行列<br/>Confusion Matrix")
    A --> G("ROC曲線・AUC<br/>ROC Curve / AUC")

    B --> B1("正しく分類できた割合<br/>最も基本的な指標")
    C --> C1("Positiveと予測したうち<br/>実際にPositiveだった割合")
    D --> D1("実際のPositiveのうち<br/>Positiveと予測できた割合")
    E --> E1("適合率と再現率の<br/>調和平均")
    F --> F1("予測と実際の結果を<br/>表で表現")
    G --> G1("しきい値を変えた性能を可視化<br/>AUCで総合評価")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef out fill:#F5ECE2,stroke:#BF8040,stroke-width:2px,color:#000
    classDef hl fill:#F9E7D9,stroke:#D55E00,stroke-width:2px,color:#000
    classDef neu fill:#F2F2F2,stroke:#8C8C8C,stroke-width:2px,color:#000
    class A neu
    class B,B1,G,G1 data
    class C,C1 proc
    class D,D1 model
    class E,E1 out
    class F,F1 hl
本節のコード例では、7.1.2 で学習した tips データセットのロジスティック回帰モデルの予測結果(y_test、y_pred)をそのまま使用します。
7.5.1 正解率(Accuracy)
正解率 は、全体のうち正しく分類できた割合です。
scikit-learn では sklearn.metrics.accuracy_score() 関数で計算します。
from sklearn.metrics import accuracy_score

accuracy = accuracy_score(y_test, y_pred)
print(f"正解率: {accuracy:.2%}")
7.5.2 混同行列(Confusion Matrix)
混同行列 は、予測結果と実際の結果を表形式で表現したものです。N クラス分類なら N×N の行列 になります(2 値分類なら 2×2、アヤメのような 3 クラス分類なら 3×3)。行が「実際のクラス」、列が「予測したクラス」を表すのが一般的です。
2 値分類の場合:
| 予測:0(Negative) | 予測:1(Positive) | |
|---|---|---|
| 実際:0(Negative) | TN(真陰性) | FP(偽陽性) |
| 実際:1(Positive) | FN(偽陰性) | TP(真陽性) |
- TP(True Positive): 正しく Positive と予測
- TN(True Negative): 正しく Negative と予測
- FP(False Positive): 誤って Positive と予測(第一種過誤)
- FN(False Negative): 誤って Negative と予測(第二種過誤)
多値分類の場合:対角成分が「正しく分類できた数」、それ以外が「どのクラスをどのクラスと取り違えたか」を表します。例えば 3 クラス分類で cm[1][2] の値は「実際はクラス 1 なのにクラス 2 と予測した数」を意味します。
TP/FP の概念は多値分類でも使える
多値分類でも、特定の 1 クラスに着目 すれば「そのクラスを Positive、それ以外を Negative」と見なすことで TP/FP/FN/TN を定義できます(One-vs-Rest)。classification_report() 関数のクラスごとの precision・recall はこの考え方で計算されています。
scikit-learn では sklearn.metrics.confusion_matrix() 関数で計算します。
from sklearn.metrics import confusion_matrix
import seaborn as sns

# 混同行列
cm = confusion_matrix(y_test, y_pred)
print("混同行列:")
print(cm)
モデルの性能について
上記の混同行列を見ると、すべてのデータがDinner(0列目)と予測されており、Lunch(1列目)と予測されたものが1つもありません(すべて0)。これは、モデルが「常にDinnerと予測する」という単純な戦略を学習してしまった状態です。
なぜこのような結果になったのか?
- 特徴量が不足:
tip(チップ)だけでは時間帯を予測するのに十分な情報がない - データの偏り:Dinnerのデータ数がLunchより多い(176件 vs 61件)
改善するにはどうすればよいか?
- 特徴量を増やす:
total_bill(合計金額)、size(人数)なども使う - カテゴリ変数を活用:
sex(性別)、smoker(喫煙者)、day(曜日)を数値化するpd.get_dummies()関数を使ってダミー変数化(One-Hot Encoding)
例:ダミー変数化
# カテゴリ変数をダミー変数化
X = pd.get_dummies(tips[['total_bill', 'tip', 'sex', 'smoker', 'day']], drop_first=True)
この例では、どの特徴量を選び、どのように加工するかによって予測結果が変わります。この作業を 特徴量エンジニアリング と呼びます。
7.5.3 適合率(Precision)
適合率(Precision) は、Positive と予測したうち、実際に Positive だった割合です。偽陽性(誤って Positive と予測すること)を減らしたいときに重視します。
scikit-learn では sklearn.metrics.precision_score() 関数で計算します。
from sklearn.metrics import precision_score

# pos_label で「Positive」とみなすクラスを指定(文字列ラベルの場合は必須)
precision = precision_score(y_test, y_pred, pos_label='Lunch')
print(f"適合率(Lunch): {precision:.2%}")
7.5.4 再現率(Recall)
再現率(Recall) は、実際の Positive のうち、Positive と予測できた割合です。偽陰性(実際は Positive なのに Negative と予測してしまうこと)を減らしたいときに重視します。
scikit-learn では sklearn.metrics.recall_score() 関数で計算します。
from sklearn.metrics import recall_score

recall = recall_score(y_test, y_pred, pos_label='Lunch')
print(f"再現率(Lunch): {recall:.2%}")
適合率と再現率のトレードオフ
適合率を重視する場合(偽陽性を減らしたい)
- スパムメール判定(普通のメールをスパムと判定するのを避けたい)
- 広告配信(興味のない人に広告を出すのを避けたい)
再現率を重視する場合(偽陰性を減らしたい)
- 病気の診断(病気を見逃さないようにしたい)
- 不正取引の検出(不正を見逃さないようにしたい)
通常、適合率と再現率はトレードオフの関係にあります。
7.5.5 F1 スコア
F1 スコア は、適合率と再現率の調和平均です。適合率と再現率のバランスを取った指標で、両方を重視したい場合に使います。
scikit-learn では sklearn.metrics.f1_score() 関数で計算します。
from sklearn.metrics import f1_score

f1 = f1_score(y_test, y_pred, pos_label='Lunch')
print(f"F1スコア(Lunch): {f1:.2%}")
7.5.6 ROC 曲線と AUC
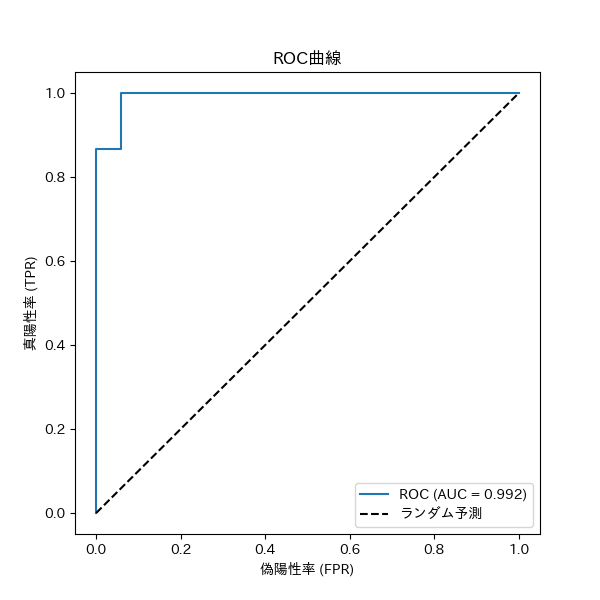
ロジスティック回帰は確率を出力するため、「どの確率以上を Positive とみなすか」という しきい値(threshold) を変えることで、適合率と再現率のバランスを調整できます。しきい値を変えながらモデルの性能を可視化したものが ROC 曲線(Receiver Operating Characteristic Curve) です。
- 横軸:偽陽性率(FPR) = FP / (FP + TN)
- 縦軸:真陽性率(TPR) = Recall = TP / (TP + FN)
graph LR
    A("ROC曲線の見方") --> B("左上に近いほど良い<br/>FPR小・TPR大")
    A --> C("対角線=ランダム予測<br/>AUC=0.5")
    A --> D("完璧なモデル<br/>AUC=1.0")

    classDef data fill:#D9EAF3,stroke:#0072B2,stroke-width:2px,color:#000
    classDef proc fill:#D9F0EA,stroke:#009E73,stroke-width:2px,color:#000
    classDef model fill:#F7EBF2,stroke:#CC79A7,stroke-width:2px,color:#000
    classDef neu fill:#F2F2F2,stroke:#8C8C8C,stroke-width:2px,color:#000
    class A neu
    class B data
    class C proc
    class D model
AUC(Area Under the Curve) は ROC 曲線の下側の面積で、0.5(ランダム)〜 1.0(完璧)の値をとります。しきい値に依存しない単一の指標としてモデル比較に便利です。
7.1.2 の例ではモデルが「常に Dinner」と予測していたため、評価指標を実感しにくいです。ここでは特徴量を増やしたうえで ROC 曲線と AUC を計算してみます。scikit-learn では sklearn.metrics.roc_curve() 関数と sklearn.metrics.roc_auc_score() 関数を使います。
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import roc_curve, roc_auc_score
import seaborn as sns

# データ準備(特徴量を増やしてダミー変数化)
tips = sns.load_dataset('tips')
X = pd.get_dummies(
    tips[['total_bill', 'tip', 'sex', 'smoker', 'day', 'size']],
    drop_first=True
)
y = (tips['time'] == 'Lunch').astype(int)  # Lunch=1, Dinner=0

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 学習
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)

# Positiveクラス(Lunch=1)の予測確率を取得
y_proba = model.predict_proba(X_test)[:, 1]

# ROC曲線とAUC
fpr, tpr, thresholds = roc_curve(y_test, y_proba)
auc = roc_auc_score(y_test, y_proba)
print(f"AUC: {auc:.3f}")

# 可視化
plt.figure(figsize=(6, 6))
plt.plot(fpr, tpr, label=f'ROC (AUC = {auc:.3f})')
plt.plot([0, 1], [0, 1], 'k--', label='ランダム予測')
plt.xlabel('偽陽性率 (FPR)')
plt.ylabel('真陽性率 (TPR)')
plt.title('ROC曲線')
plt.legend()
plt.show()
predict と predict_proba の違い
model.predict(X):予測クラス(例:'Lunch'or'Dinner')を返すmodel.predict_proba(X):各クラスに属する確率を返す(行ごとに合計1.0)
しきい値を変えた評価や ROC/AUC の計算には predict_proba() メソッドが必要です。
Playground:ROC 曲線と AUC
ROC曲線とAUC の Playground では、しきい値スライダーを動かすと、左のスコア分布の縦線と右の ROC 曲線上の点が連動します。しきい値を緩めると TPR(再現率)は上がるが FPR(誤検知率)も上がるトレードオフを体感し、「分離度」を上げると 2 つの山が離れて ROC が左上に張りつき AUC が 1 に近づくことも確かめてみましょう。
7.6 演習問題
演習 7-1: ロジスティック回帰
演習 7-1
tips データセットを使って、食事の情報から時間帯(time:Lunch / Dinner)を予測するロジスティック回帰を実装してください。
タスク:
- tips データセットを読み込み、先頭 5 行を表示する
- 特徴量
X = tips[['total_bill', 'tip', 'size']]、ラベルy = tips['time']を準備する - データを「訓練 80%、テスト 20%」(
random_state=42)に分割する - ロジスティック回帰モデル
LogisticRegression(max_iter=1000)を学習する - テストデータで予測し、正解率(accuracy)を計算して表示する
- 学習された各特徴量の「係数」と「切片」を表示し、どの特徴量が予測に効いているか確認する
- 特徴量を
tipの 1 列だけにした場合の正解率を求めて 3 特徴量の場合と比較し、特徴量の数がモデル性能に与える影響を考察する
import seaborn as sns
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 1. データの読み込みと先頭 5 行の表示

# 2. 特徴量 X とラベル y の設定

# 3. 訓練・テストに分割(8:2, random_state=42)

# 4. モデルの作成と学習

# 5. テストデータで予測し、正解率を表示

# 6. 係数と切片の表示

# 7. tip の 1 列だけで学習した場合との正解率比較
解答例
import seaborn as sns
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 1. データの読み込みと先頭5行の表示
tips = sns.load_dataset("tips")
print(tips.head())

# 2. 特徴量 X とラベル y の設定
X = tips[["total_bill", "tip", "size"]]
y = tips["time"]

# 3. 訓練データとテストデータに分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 4. モデルの作成と学習
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)

# 5. テストデータで予測し、正解率を表示
y_pred = model.predict(X_test)
print(f"正解率: {accuracy_score(y_test, y_pred):.4f}")

# 6. 係数と切片の表示
for name, coef in zip(X.columns, model.coef_[0]):
    print(f"{name}: {coef:.4f}")
print(f"切片: {model.intercept_[0]:.4f}")

# 7. tip の1列だけを特徴量にした場合との比較
X1 = tips[["tip"]]
X1_train, X1_test, y1_train, y1_test = train_test_split(
    X1, y, test_size=0.2, random_state=42
)
model1 = LogisticRegression(max_iter=1000)
model1.fit(X1_train, y1_train)
y1_pred = model1.predict(X1_test)
print(f"正解率(tip のみ): {accuracy_score(y1_test, y1_pred):.4f}")
   total_bill   tip     sex smoker  day    time  size
0       16.99  1.01  Female     No  Sun  Dinner     2
1       10.34  1.66    Male     No  Sun  Dinner     3
2       21.01  3.50    Male     No  Sun  Dinner     3
3       23.68  3.31    Male     No  Sun  Dinner     2
4       24.59  3.61  Female     No  Sun  Dinner     4
正解率: 0.6735
total_bill: -0.0883
tip: 0.0555
size: 0.0572
切片: 0.3732
正解率(tip のみ): 0.6939
考察:2値分類の係数は、アルファベット順で後のクラス(ここでは Lunch)への寄与を表します。total_bill の係数が負なので、会計金額が大きいほど Dinner と予測されやすくなります。ただし標準化をしていないため、係数の絶対値を特徴量の重要度として比べることはできません。また、tip のみの正解率 0.6939 は、テストデータに占める Dinner の割合(34/49 件)と同じ値です。3 特徴量に増やすと 0.6735 に下がっており、特徴量を増やせば性能が上がるとは限りません。予測の内訳は演習 7-3 の混同行列で確認します。
演習 7-2: k-近傍法の基礎
演習 7-2
iris データセットを使って、4 つの数値特徴量からアヤメの種類(species)を分類する k-近傍法を実装してください。k-NN は距離ベースの手法なので、特徴量の標準化をセットで行います。
タスク:
- iris データセットを読み込み、特徴量
X(sepal_length,sepal_width,petal_length,petal_widthの 4 列)とラベルy = iris['species']を準備する - データを「訓練 80%、テスト 20%」(
random_state=42)に分割する StandardScalerクラスで特徴量を標準化する(訓練データでfit_transform()メソッド、テストデータはtransform()メソッドのみ)- k-NN モデル
KNeighborsClassifier(n_neighbors=5)を学習する - テストデータで予測し、正解率を表示する
classification_report()関数でクラスごとの適合率・再現率・F1 スコアを表示するn_neighborsを 1, 3, 5, 7, 9, 11, 15, 21, 31 と変えて訓練データとテストデータの正解率を比較し、k の値が結果に与える影響を考察する
import seaborn as sns
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, classification_report

# 1. データの読み込みと特徴量 X・ラベル y の設定

# 2. 訓練・テストに分割(8:2, random_state=42)

# 3. StandardScaler で標準化

# 4. k-NN モデル(n_neighbors=5)の学習

# 5. テストデータで予測し、正解率を表示

# 6. classification_report の表示

# 7. k を変えて訓練・テスト正解率を比較
解答例
import seaborn as sns
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, classification_report

# 1. データの読み込みと特徴量 X・ラベル y の設定
iris = sns.load_dataset("iris")
X = iris[["sepal_length", "sepal_width",
          "petal_length", "petal_width"]]
y = iris["species"]

# 2. 訓練データとテストデータに分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 3. StandardScaler で標準化
scaler = StandardScaler()
X_train_s = scaler.fit_transform(X_train)
X_test_s = scaler.transform(X_test)

# 4. k-NN モデル(n_neighbors=5)の学習
model = KNeighborsClassifier(n_neighbors=5)
model.fit(X_train_s, y_train)

# 5. テストデータで予測し、正解率を表示
y_pred = model.predict(X_test_s)
print(f"正解率: {accuracy_score(y_test, y_pred):.4f}")

# 6. classification_report の表示
print(classification_report(y_test, y_pred))

# 7. k を変えて訓練・テスト正解率を比較
for k in [1, 3, 5, 7, 9, 11, 15, 21, 31]:
    m = KNeighborsClassifier(n_neighbors=k)
    m.fit(X_train_s, y_train)
    train_acc = accuracy_score(y_train, m.predict(X_train_s))
    test_acc = accuracy_score(y_test, m.predict(X_test_s))
    print(f"k={k:2d}: 訓練 {train_acc:.4f}, テスト {test_acc:.4f}")
正解率: 1.0000
              precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        10
  versicolor       1.00      1.00      1.00         9
   virginica       1.00      1.00      1.00        11

    accuracy                           1.00        30
   macro avg       1.00      1.00      1.00        30
weighted avg       1.00      1.00      1.00        30

k= 1: 訓練 1.0000, テスト 1.0000
k= 3: 訓練 0.9417, テスト 1.0000
k= 5: 訓練 0.9583, テスト 1.0000
k= 7: 訓練 0.9583, テスト 1.0000
k= 9: 訓練 0.9500, テスト 1.0000
k=11: 訓練 0.9583, テスト 1.0000
k=15: 訓練 0.9583, テスト 1.0000
k=21: 訓練 0.9500, テスト 1.0000
k=31: 訓練 0.9250, テスト 0.9667
考察:k=5 では 30 件のテストデータをすべて正しく分類できました。アヤメはクラスがよく分かれているデータです。k=1 では訓練正解率が 1.0000 になります。訓練データでは自分自身が最近傍になるためで、過学習の兆候です。k=3〜21 ではテスト正解率が 1.0000 のままですが、k=31 まで大きくすると広い範囲の多数決になって決定境界がなめらかになりすぎ、訓練・テストとも正解率が下がります(未学習)。
演習 7-3: 混同行列と評価指標
演習 7-3
分類モデルの評価指標を、手計算と実装の両面から確認します。
(a)手計算
あるモデルで以下の混同行列が得られたとします。この混同行列から、各評価指標を手計算で求めてください。
| 予測:Negative | 予測:Positive | |
|---|---|---|
| 実際:Negative | 85 | 10 |
| 実際:Positive | 5 | 50 |
- 正解率(Accuracy)を求める
- 適合率(Precision)を求める
- 再現率(Recall)を求める
- F1 スコアを求める
- このモデルの性能について一言で評価する
(b)実装での確認
演習 7-1 と同じロジスティック回帰モデル(tips, total_bill・tip・size → time)について、混同行列・適合率・再現率・F1 スコアを計算し、結果を読み取って考察してください。
- 演習 7-1 と同じ設定でモデルを学習し、テストデータを予測する
confusion_matrix()関数をlabels=['Dinner', 'Lunch']指定で計算し、配列を表示するseabornのヒートマップで混同行列を可視化するLunchを Positive(pos_label='Lunch')として適合率・再現率・F1 スコアを計算・表示するclassification_report()関数でクラスごとの指標を表示する- 出力結果を見て、「どちらのクラスを間違えやすいか・なぜそうなるのか」をコメントで考察する
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import (confusion_matrix, precision_score,
                             recall_score, f1_score, classification_report)

# 1. 演習 7-1 と同じモデルを学習し、テストデータを予測

# 2. confusion_matrix の計算と表示(labels=['Dinner', 'Lunch'])

# 3. ヒートマップで混同行列を可視化

# 4. Lunch を Positive とした適合率・再現率・F1 スコア

# 5. classification_report の表示

# 6. 考察(どのクラスを間違えやすいか・なぜか)をコメントで記述
解答例
(a)手計算
与えられた混同行列は次のとおりです(TN=85, FP=10, FN=5, TP=50)。
- 正解率(Accuracy)
- 適合率(Precision)
- 再現率(Recall)
- F1 スコア
- 評価:正解率90%でありF1スコアも0.87と比較的高く、バランスの取れた分類性能を持つモデルといえます。適合率(0.833)より再現率(0.909)のほうが高いため、「Positive の取りこぼしは少ないが、Negative を Positive と誤判定するケース(FP=10)がやや多い」傾向があります。
(b)実装での確認
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import (confusion_matrix, precision_score,
                             recall_score, f1_score, classification_report)

# 1. 演習 7-1 と同じモデルを学習し、テストデータを予測
tips = sns.load_dataset("tips")
X = tips[["total_bill", "tip", "size"]]
y = tips["time"]
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)

# 2. confusion_matrix の計算と表示
cm = confusion_matrix(y_test, y_pred, labels=["Dinner", "Lunch"])
print("混同行列:")
print(cm)

# 3. ヒートマップで混同行列を可視化
plt.figure(figsize=(5, 4))
sns.heatmap(cm, annot=True, fmt="d", cmap="Blues",
            xticklabels=["Dinner", "Lunch"],
            yticklabels=["Dinner", "Lunch"])
plt.xlabel("Predicted")
plt.ylabel("Actual")
plt.show()

# 4. Lunch を Positive とした適合率・再現率・F1 スコア
precision = precision_score(y_test, y_pred, pos_label="Lunch")
recall = recall_score(y_test, y_pred, pos_label="Lunch")
f1 = f1_score(y_test, y_pred, pos_label="Lunch")
print(f"適合率: {precision:.4f}")
print(f"再現率: {recall:.4f}")
print(f"F1スコア: {f1:.4f}")

# 5. classification_report の表示
print(classification_report(y_test, y_pred))
混同行列:
[[33  1]
 [15  0]]
適合率: 0.0000
再現率: 0.0000
F1スコア: 0.0000
              precision    recall  f1-score   support

      Dinner       0.69      0.97      0.80        34
       Lunch       0.00      0.00      0.00        15

    accuracy                           0.67        49
   macro avg       0.34      0.49      0.40        49
weighted avg       0.48      0.67      0.56        49
実行すると、混同行列の各セルの件数を色の濃さで表したヒートマップも表示されます。左上(Dinner を Dinner と予測した 33 件)だけが濃く、右下(Lunch を Lunch と予測できた件数)が 0 であることがひと目でわかります。
考察:間違えやすいのは Lunch です。テストデータの Lunch 15 件はすべて Dinner と判定され、Lunch の再現率と F1 スコアは 0 です。tips データは Dinner が 176 件、Lunch が 68 件と Dinner に偏っています。さらに会計金額・チップ・人数の分布が両者で大きく重なっていて、この 3 特徴量では区別がつきません。正解率 0.67 はそれなりに見えますが、ほぼすべてを Dinner と答えるモデルになっていて、全部を Dinner と答えた場合(34/49 = 0.69)より低くなっています。
演習 7-4: 4 モデルの比較
演習 7-4
iris データセットで、本章で学んだ 4 つの分類モデル(ロジスティック回帰、ナイーブベイズ、k-NN、SVM)を比較してください。
タスク:
- 全特徴量(4 列)を使用し、標準化を行う
- データを「訓練 80%、テスト 20%」(
random_state=42)に分割する - 4 つのモデルそれぞれについて正解率と F1 スコア(
average='macro')を求める - 結果を表にまとめて表示する
- どのモデルが最も高い性能を示したか確認する
import pandas as pd
import seaborn as sns
from sklearn.linear_model import LogisticRegression
from sklearn.naive_bayes import GaussianNB
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import accuracy_score, f1_score

# 1. データの読み込みと特徴量・ラベルの設定

# 2. 訓練・テストに分割(8:2, random_state=42)と標準化

# 3. 4 つのモデルの正解率と F1 スコア(average='macro')を計算

# 4. 結果を表にまとめて表示

# 5. 最も性能の高いモデルを確認
解答例
import pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.naive_bayes import GaussianNB
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import accuracy_score, f1_score
import seaborn as sns

# 1. 全特徴量を使用し、標準化を行う
iris = sns.load_dataset("iris")
X = iris[["sepal_length", "sepal_width",
          "petal_length", "petal_width"]].values
y = iris["species"].values

# 2. 訓練データとテストデータに分割
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)
scaler = StandardScaler()
X_train_s = scaler.fit_transform(X_train)
X_test_s = scaler.transform(X_test)

# 3. 4つのモデルの正解率と F1スコアを求める
models = {
    "ロジスティック回帰": LogisticRegression(
        max_iter=200, random_state=42),
    "ナイーブベイズ": GaussianNB(),
    "k-NN (k=5)": KNeighborsClassifier(n_neighbors=5),
    "SVM (RBF)": SVC(kernel="rbf", random_state=42),
}
results = []
for name, model in models.items():
    model.fit(X_train_s, y_train)
    y_pred = model.predict(X_test_s)
    acc = accuracy_score(y_test, y_pred)
    f1 = f1_score(y_test, y_pred, average="macro")
    results.append({
        "モデル": name,
        "正解率": f"{acc:.2%}",
        "F1スコア": f"{f1:.4f}"
    })

# 4. 結果を表にまとめて表示
result_df = pd.DataFrame(results)
print(result_df.to_string(index=False))
      モデル     正解率  F1スコア
ロジスティック回帰 100.00% 1.0000
  ナイーブベイズ 100.00% 1.0000
k-NN (k=5) 100.00% 1.0000
SVM (RBF) 100.00% 1.0000
考察:この分割(random_state=42)では4つのモデルすべてが正解率100%で、差は出ませんでした。アヤメはクラスがよく分かれた易しいデータだからです。random_state を変えたり特徴量を減らしたりすると、モデルの差が見えてきます。
演習 7-5: SVM とハイパーパラメータ
演習 7-5
penguins データセットを使って、bill_length_mm・bill_depth_mm・body_mass_g の 3 つの数値特徴量からペンギンの種類(species:Adelie / Chinstrap / Gentoo)を分類する SVM(RBF カーネル)を実装してください。また、マージン違反のペナルティ C を複数の値で試し、精度の変化を確認してください。
タスク:
- penguins データセットを読み込み、
dropna()メソッドで欠損値を削除する - 特徴量
bill_length_mm・bill_depth_mm・body_mass_gの 3 列とラベルspeciesを準備し、訓練 80%・テスト 20% に分割する(random_state=42) StandardScalerクラスで特徴量を標準化する(訓練データでfitし、テストデータにはtransformのみを適用)SVC(kernel='rbf', gamma='scale', random_state=42)のCを[0.01, 0.1, 1, 10, 100]の 5 つの値で試し、テスト精度を比較するCと性能の関係性について、コメントで考察する
import seaborn as sns
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 1. データの読み込みと欠損値の削除

# 2. 特徴量 X とラベル y の設定 + 訓練・テストに分割(8:2, random_state=42)

# 3. StandardScaler で標準化(訓練データで fit_transform、テストデータは transform)

# 4. 複数の C で SVM(RBF)を学習し、精度を比較

# 5. 考察をコメントで記述
解答例
import seaborn as sns
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 1. データの読み込みと欠損値の削除
penguins = sns.load_dataset("penguins").dropna()

# 2. 特徴量 X とラベル y の設定 + 訓練・テストに分割
X = penguins[["bill_length_mm", "bill_depth_mm", "body_mass_g"]]
y = penguins["species"]
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 3. StandardScaler で標準化
scaler = StandardScaler()
X_train_s = scaler.fit_transform(X_train)
X_test_s = scaler.transform(X_test)

# 4. 複数の C で SVM(RBF)を学習し、精度を比較
for C in [0.01, 0.1, 1, 10, 100]:
    model = SVC(kernel="rbf", gamma="scale", C=C, random_state=42)
    model.fit(X_train_s, y_train)
    y_pred = model.predict(X_test_s)
    acc = accuracy_score(y_test, y_pred)
    print(f"C={C:>6}: 正解率 {acc:.4f}")
考察:C はマージン違反へのペナルティの強さです。C=0.01 では誤分類を許しすぎて決定境界が単純になり、正解率は 77.6% にとどまります(未学習)。C=1 と C=10 では 100% に達しますが、C=100 では訓練データに合わせすぎて 98.5% にわずかに下がります(過学習の兆候)。適切な C はデータによって変わるので、第 5 章の GridSearchCV クラスなどで探します。
7.7 まとめ
本章では、分類問題の基礎、ロジスティック回帰、ナイーブベイズ、k-近傍法、サポートベクターマシン(SVM)について学びました。
第 7 章のまとめ
分類問題の基礎
- 回帰は数値予測、分類はカテゴリ予測
- 2値分類(2クラス)と多値分類(3クラス以上)
- 実務での応用範囲が広い
ロジスティック回帰
- シグモイド関数で確率を出力
- 線形な決定境界
- シンプルで解釈しやすい
- 多値分類にも対応可能
ナイーブベイズ
- ベイズの定理に基づく確率的な分類手法
- 学習が高速で、少ないデータでも安定する
- 特徴量の独立性を仮定(テキスト分類と相性が良い)
k-近傍法(k-NN)
- 近い k 個のデータの多数決でクラスを決定
- 学習はせずに訓練データを記憶するだけ(怠惰学習)
- 非線形な決定境界を表現できる
- 距離の影響を受けるため、通常は標準化する
n_neighbors(k)の選び方が重要
サポートベクターマシン(SVM)
- マージン最大化で境界を引く幾何的な分類手法
- カーネルトリックで非線形な境界も扱える
- 通常は標準化する。データ量が増えると学習コストが高くなりやすい
評価指標
- 正解率(Accuracy):基本的な指標
- 混同行列(Confusion Matrix):予測の詳細を把握
- 適合率(Precision):偽陽性を重視
- 再現率(Recall):偽陰性を重視
- F1スコア:適合率と再現率のバランス
- ROC 曲線 / AUC:しきい値に依存しない総合的な性能評価
次章では、より複雑な分類モデルとして決定木やランダムフォレストなどの木構造とアンサンブル学習を扱います。